Kimi K3.1 Pro Highspeed это тот же флагман Moonshot, но в два-три раза быстрее. Цена выше ровно вдвое: $4 за миллион входных токенов и $20 за выходные против $2 и $10. Контекст тот же миллион, попадание в кэш тоже $0.20. Платить стоит там, где человек ждёт ответа, а не в ночной пакетной обработке.
Moonshot выпустила две версии одной модели. Обычная стоит $2 за вход и $10 за выход, Highspeed стоит вдвое дороже и работает в два-три раза быстрее. Возникает вопрос, который редко задают в обзорах: за что именно вы платите вторые десять долларов.
Ответ зависит не от модели, а от того, сколько стоит ваше ожидание.
Что такое Kimi K3.1 Pro Highspeed
Это тот же K3.1 Pro, без урезанных возможностей. В документации сказано прямо: Highspeed работает в два-три раза быстрее, чтобы взаимодействие было отзывчивее. Контекст тот же миллион токенов, веса обещают открыть до 4 ноября 2026 года.
Модель постобучена на базе Kimi K3, это флагман серии K3.1. В блоге Moonshot её сильные стороны перечислены честно: код, 3D, финансовый анализ, агентные задачи. Highspeed не меняет эти характеристики, только скорость выдачи.
Идентификатор для API простой: kimi-k3.1-pro-highspeed. Рядом живёт обычный kimi-k3.1-pro.
Цена: что именно удваивается
Официальный прайс выглядит так.
- Вход: $4 за миллион против $2 у обычной.
- Выход: $20 против $10.
- Попадание в кэш: $0.20 у обеих версий.
- Запись в кэш: $4 за пятиминутный TTL и $8 за часовой, против $2 и $4 у обычной.
Кэш это важная деталь. Если у вас длинный системный промпт и повторяющийся контекст, попадания стоят одинаково, а дорожает только запись. В сценариях с большим объёмом кэшируемого входа разница в счёте будет меньше, чем удвоенная.
Считать надо не «дороже в два раза», а по формуле: доля попаданий в кэш, доля новых записей, объём выхода. Для агентных циклов с короткими ответами и большим контекстом это даёт расхождение в разы.
Арифметика ожидания
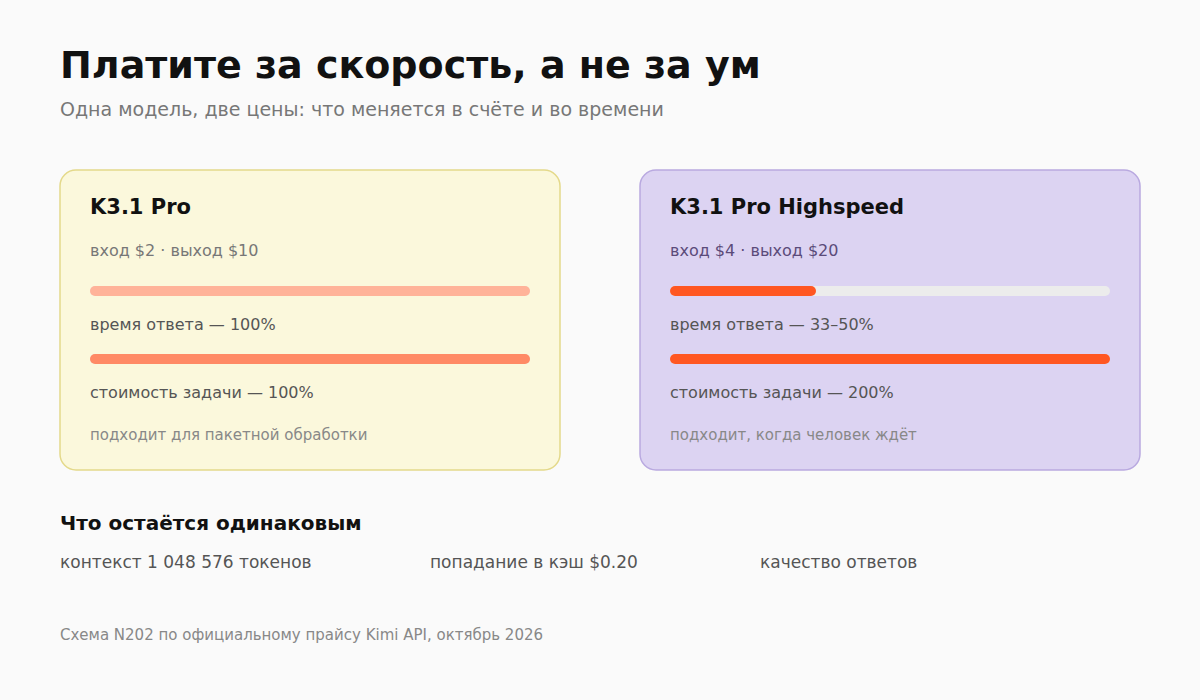
Разница в цене фиксированная, разница в скорости плавающая. Официально это два-три раза, значит на одном и том же тексте Highspeed выдаст ответ за 33–50% времени обычной версии.
Отсюда простая метрика: стоимость минуты ожидания. Если обычная модель решает задачу за три минуты и стоит условные 10 центов, а быстрая за полторы минуты и стоит 20, то в пересчёте на время работы вы платите примерно на 20% меньше. Но за саму задачу платите вдвое больше.
Что это значит на практике. Для пакетной обработки, где никто не ждёт, обычная версия выгоднее всегда. Для интерактивных сценариев, где человек сидит перед экраном, быстрая версия окупается не деньгами за токены, а стоимостью простоя.
Когда Highspeed действительно нужен
Живой редактор или ассистент: самый очевидный случай. Человек ждёт ответа после каждого действия, и три минуты вместо полутора превращают работу в пытку. С агентными циклами та же история: когда модель десять раз подряд вызывает инструменты, задержка умножается на число шагов, и разница в скорости перевешивает разницу в цене. Генерация серии тоже упирается в ожидание: двадцать вариантов сценария, десять черновиков писем, пять версий описания товара. Если результат нужен человеку сейчас, быстрая версия экономит его время, а не только деньги. Демонстрации и созвоны добивают картину: показывать клиенту, как агент думает две минуты, неприятно.
Обратная сторона тоже понятна. Ночная пакетная обработка, разбор архива документов, фоновые задачи без человека: там вы платите за скорость, которую никто не заметит.
Что это даёт контентмейкеру
Для контента выигрыш заметен на черновиках серии: один запрос с контекстом проекта, двадцать вариантов заходов, отбор вручную. Обычная модель справится, но ждать придётся дольше. Правки в диалоге («сократи до тридцати секунд», «сделай монтаж плотнее», «перепиши под вертикаль») упираются в скорость ещё сильнее, и быстрая версия ощущается как другой инструмент. Когда агент сам собирает раскадровку и проверяет тайминги, эффект накапливается с каждым шагом.
Есть и ограничение: модель всегда думает. Отключить размышления нельзя, можно только понизить усилие через reasoning_effort до low. На простых задачах это сокращает расход токенов и время.
Ограничения и подводные камни
Размер ответа по умолчанию 131 072 токена, максимум 1 048 576. Для длинных сценариев и больших файлов этого хватает, но счёт растёт пропорционально.
Доступ к флагманской модели открывается после пополнения баланса, минимальный порог символический. Лимиты запросов зависят от суммы пополнений, это стоит проверить до запуска серии.
Кэш живёт пять минут по умолчанию. Если между запросами пауза больше, выбирайте часовой TTL, иначе запись будет происходить заново и вы заплатите дважды.
Для команд есть вариант Kimi Business с разделением личных и рабочих аккаунтов. Если данные нельзя отдавать наружу, смотрите на условия Zero Data Retention в API.
Как включить и что проверить
В API достаточно заменить идентификатор модели на kimi-k3.1-pro-highspeed. Код запроса не меняется.
В продуктах Kimi Highspeed включён в тариф Pro и выше, на вебе, в Kimi Work и Kimi Code. На бесплатном и Plus его нет.
Перед покупкой тарифа прогоните один и тот же набор задач на двух версиях. Замерьте три числа: время до первого токена, общее время ответа и стоимость запроса. Если выигрыш по времени меньше тридцати процентов, переплата не оправдана.
Отдельно стоит помнить: скорость не улучшает качество. Если модель ошибается в задаче, Highspeed ошибётся быстрее и дороже. Сначала проверьте, что обычная версия справляется, потом ускоряйте.