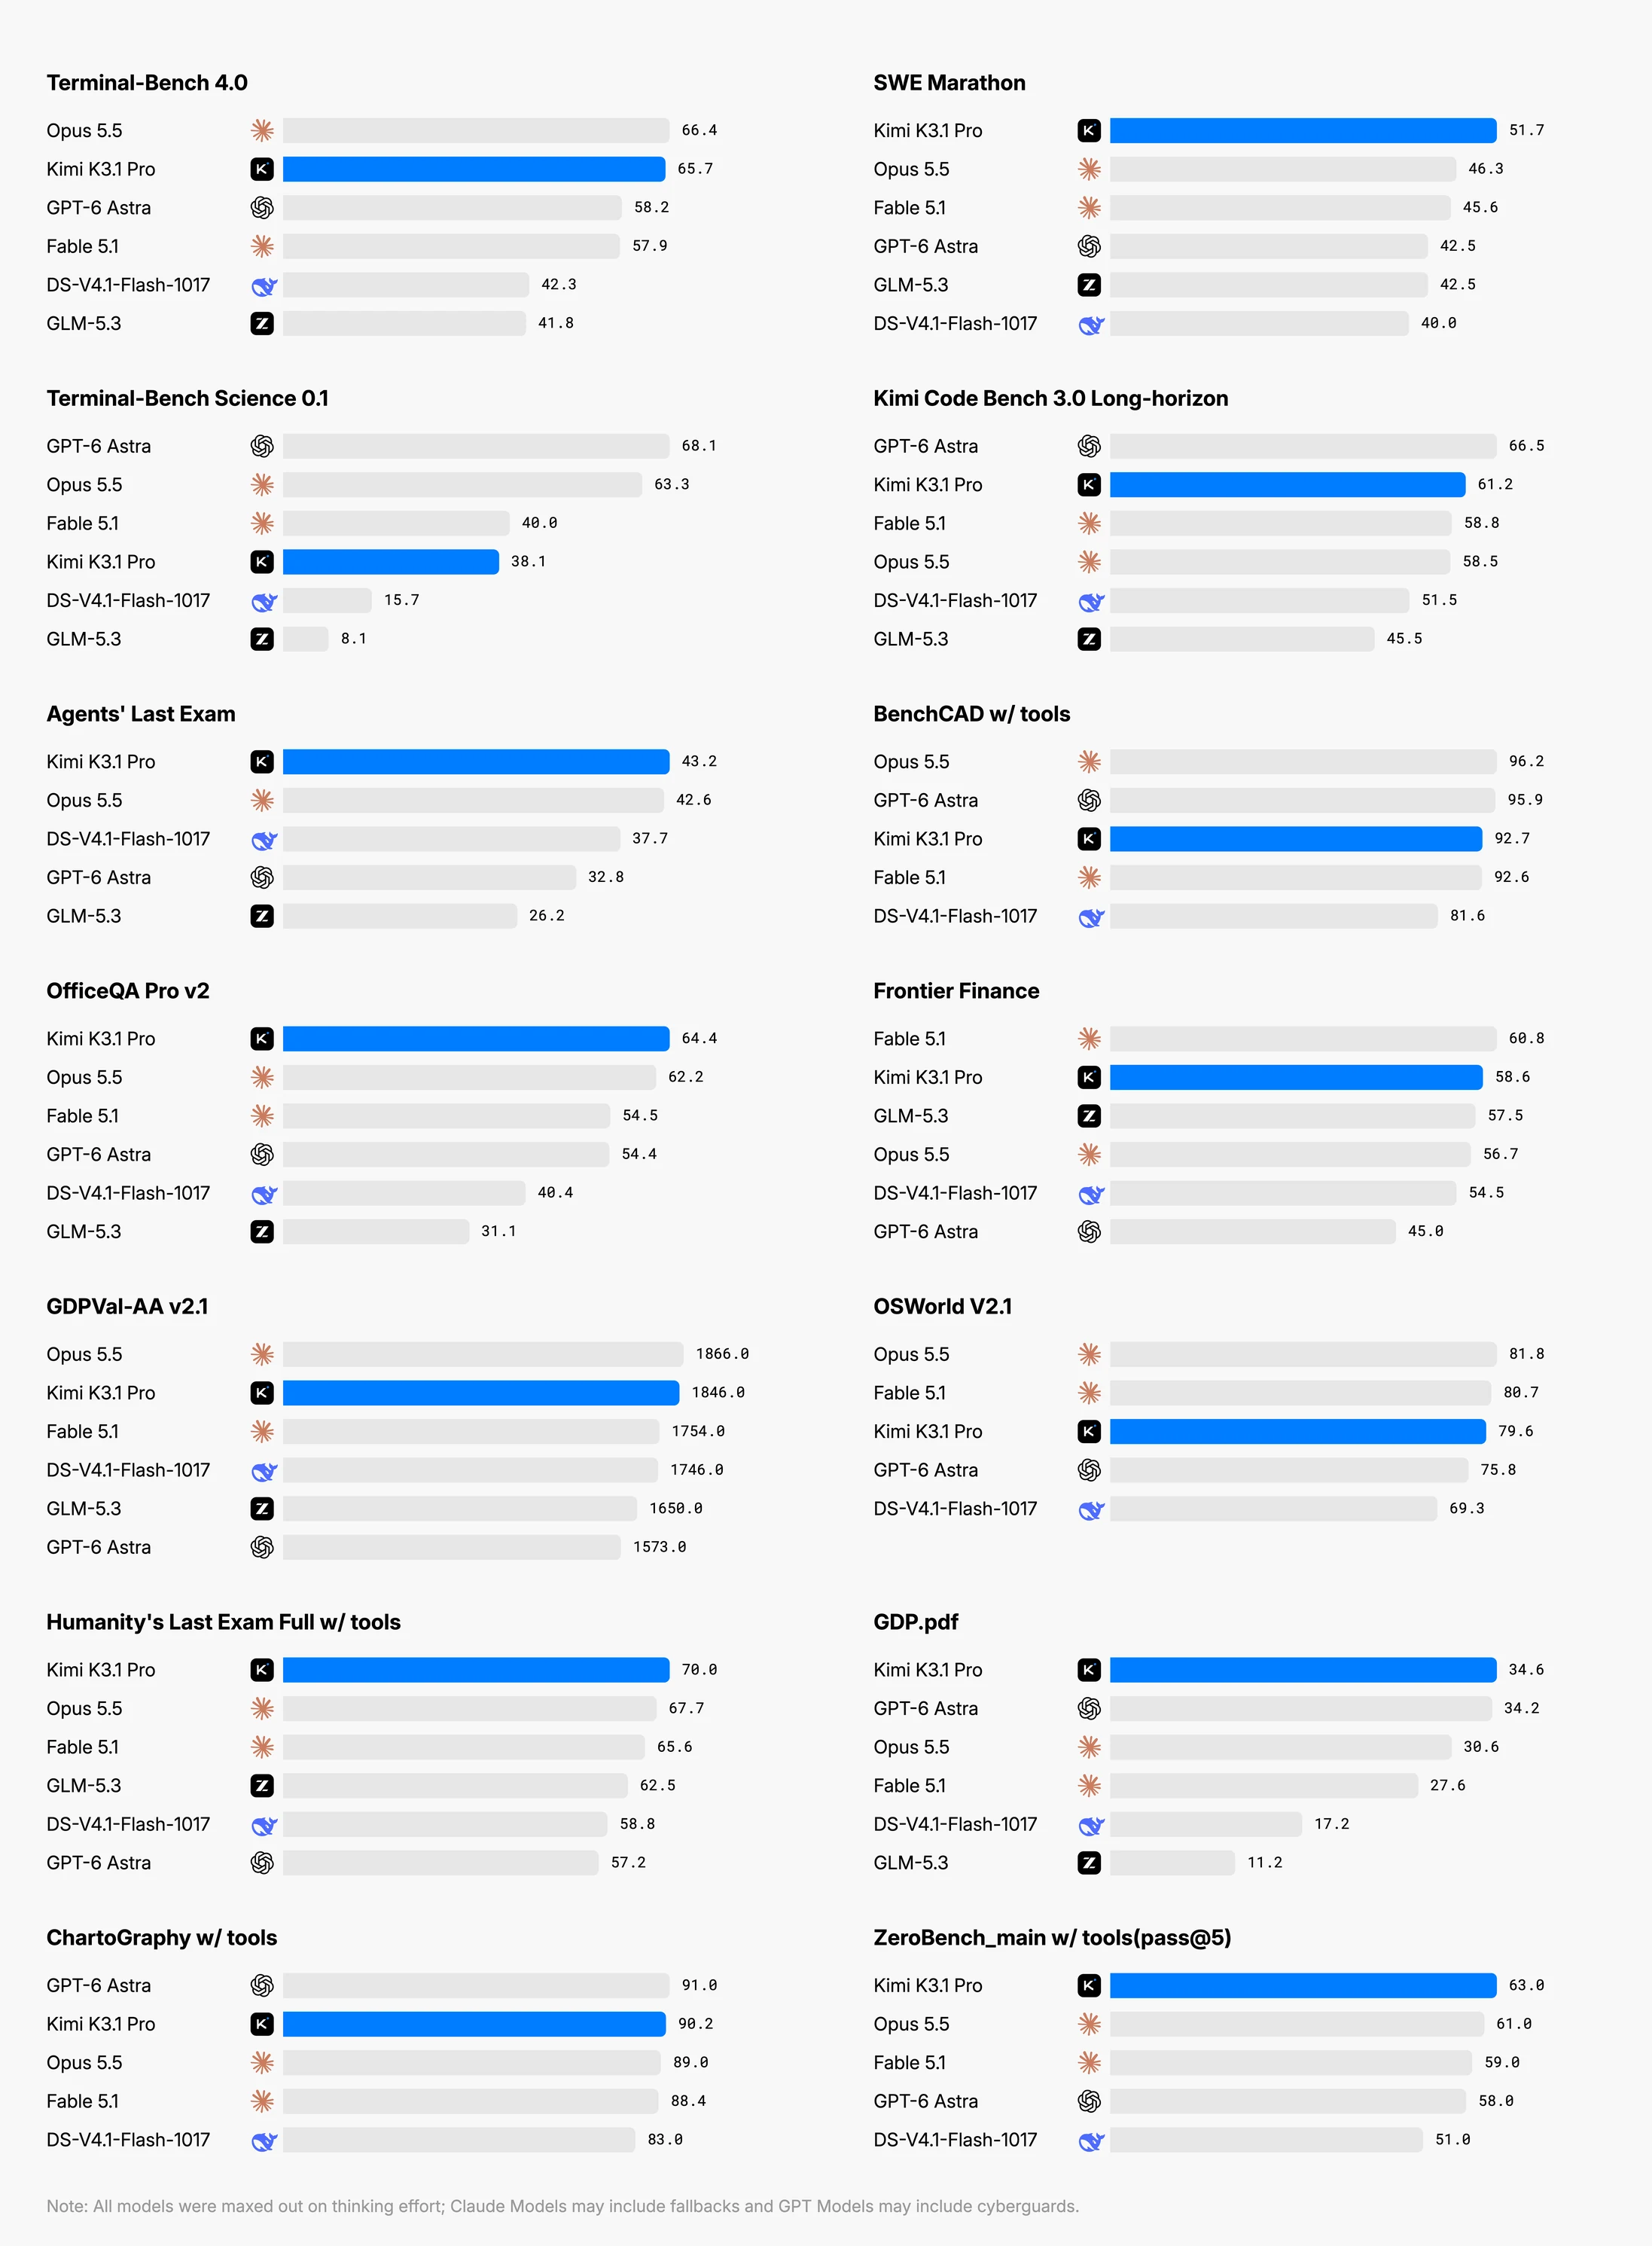
Kimi K3.1 Pro — дообученная K3 с контекстом 1M токенов и открытыми весами до 4 ноября. На Terminal-Bench 4.0 модель набирает 65,7% против 58,2% у GPT-6 Astra и 66,4% у Claude Opus 5.5, а стоит $2 за миллион входных и $10 за выходные — вдвое дешевле Opus.
23 октября Moonshot выкатила Kimi K3.1 Pro: не новую архитектуру, а серьёзно дообученную K3. Заявка наглая: на Terminal-Bench 4.0 модель набирает 65,7% против 58,2% у GPT-6 Astra и всего на 0,7 пункта отстаёт от Claude Opus 5.5.
При этом вход стоит $2 за миллион токенов против $4 у Opus. Для агентских задач, где модель гоняет туда-сюда десятки тысяч токенов, разница в цене важнее десятых долей процента в бенчмарке.
Что именно вышло
K3.1 Pro это K3, дообученная большим объёмом RL по сотням прикладных доменов. Заявленный класс — 3 триллиона параметров, контекст миллион токенов, открытые веса.
Вместе с ней выпустили Highspeed-вариант: те же качества, но в 2–3 раза быстрее. Работает на Kimi.ai, в Kimi Work, Kimi Code и через API. Полные веса обещают выложить до 4 ноября.
API-идентификаторы простые: kimi-k3.1-pro и kimi-k3.1-pro-highspeed. В модели всегда включён режим рассуждения, уровень задаётся полем reasoning_effort: low, high или max, по умолчанию max.
Цифры, которые важнее слов
Смотрим на официальную таблицу. Terminal-Bench 4.0: 65,7%, у Opus 5.5: 66,4%. SWE Marathon: 51,7% против 46,3% у Opus, то есть в длинных инженерных задачах модель уже впереди. Agents' Last Exam: 43,2 против 42,6.
На BenchCAD, где проверяется 3D-реконструкция через генерацию CAD-кода, у K3.1 Pro 92,7% с инструментами против 96,2% у Opus и 95,9% у GPT-6 Astra. Без инструментов разрыв почти исчезает: 72,8 против 73,0.
OfficeQA Pro v2, финансовая аналитика по реальным документам: 64,4: лучший результат в таблице, выше Opus 5.5 с 62,2. Humanity's Last Exam с инструментами: 70,0 против 67,7 у Opus.
Есть и просадки. Kimi Code Bench 3.0 Long-horizon: 61,2 против 66,5 у GPT-6 Astra. OSworld 2.1: 79,6 против 81,8 у Opus. Frontier Finance: 58,6 против 60,8 у Fable 5.1.
Сколько это стоит
Цены официальные, с прайса платформы. kimi-k3.1-pro: $2 за миллион входных токенов, $10 за выходные, $0,20 за кэшированный вход. Запись в кэш на 5 минут стоит $2, на час — $4.
Highspeed дороже ровно вдвое: $4 и $20. Для сравнения, старая K3 стоит $3 и $15, а Opus 5.5: $4 и $20.
Простой расчёт для агента поддержки на 3 000 диалогов по 3 000 входных и 800 выходных токенов: 9 миллионов входных и 2,4 миллиона выходных дают $18 и $24, итого $42 в месяц. У Opus 5.5 та же нагрузка стоила бы $84.
Длинные задачи: главный аргумент
В блоге есть показательный кейс. Модель получила симулятор ходьбы на основе анатомической модели человека с 296 костями и 402 мышцами. За 167 миссий и 420 независимых проверок она сама анализировала результаты, ставила диагнозы и переписывала контроллер.
Когда правка наград не помогла, модель не стала крутить коэффициенты дальше: она прогнала открытые тесты динамики симулятора, нашла и исправила 36 ошибок в расчёте моментов плеча мышц, а потом переобучила контроллер. Итог: человек в симуляции перестал падать за секунды и прошёл 11,2 секунды попеременным шагом.
Именно такие истории, а не проценты, показывают, зачем нужен миллион токенов контекста и длинное RL: модель держит задачу часами и не теряет нить.
3D и фронтенд
Moonshot отдельно подчёркивает работу с Unity, Unreal Engine и Godot, а также с Three.js. Модель пишет интерактивные сцены, генерирует 3D-ассеты и собирает параметрические модели — от механических деталей до мебели, без MCP-коннекторов, просто скриптами для Blender и CAD.
На сайте Kimi появился режим 3D Make: можно собрать модель по промпту, отредактировать её в браузере, скачать под 3D-печать или экспортировать видео.
Для контента это значит одно: обложки, 3D-иконки и заставки можно делать в том же агенте, где пишется текст, не переключаясь между сервисами.
Галлюцинации и финансы
Moonshot заявляет, что на внутреннем стресс-тесте Kimi Hallu Bench Hard доля фактических ошибок на уровне утверждений упала с 23,4% у K3 до 8,3%. Для финансового анализа это важнее, чем рост на пару пунктов в общем рейтинге.
Внутренние финансы тоже выросли: моделирование 57,6 против 50,4, исследование 70,4 против 58,8, бизнес-операции 37 против 8,9. Цифры вендорские, но направление совпадает с OfficeQA.
Где ограничения
Первое: бенчмарки свои. Moonshot сама составляет таблицу, сама выбирает условия и сама судит некоторые тесты. Независимые прогоны появятся через недели.
Второе: весов пока нет. До 4 ноября K3.1 Pro остаётся облачной моделью с API, а не то, что можно запустить на своём железе.
Третье: рассуждение всегда включено. На простых задачах max по умолчанию сжигает токены на размышления, поэтому для рутины ставьте low.
Четвёртое: кибербезопасность сознательно урезана. Moonshot удалила киберданные из mid-training и отфильтровала соответствующие RL-среды: на внутреннем xdev-bench-hard без этих мер было бы 90,5%, а в финальной модели 81,0%. Для защиты это нормально, для пентеста — нет.
Пятое: миллион токенов контекста стоит денег. Каждый запрос с полным контекстом оплачивается по $2 за миллион, поэтому длинный контекст выгоден только там, где он реально нужен.
Итог
K3.1 Pro не «убийца Opus», но очень неудобный конкурент. Она проигрывает там, где нужна тонкая работа с интерфейсами и длинные цепочки кода, и выигрывает в цене, 3D и финансовой аналитике. Если у вас агент, который делает много вызовов в сутки, разница в $2 против $4 на входе окупается быстрее, чем кажется.
Больше разборов моделей и готовых схем для агентов в Telegram-канале N2D2 AI.