FLUX 3 Klein — открытая модель Black Forest Labs на 5,6 млрд параметров. Она делает картинки до 4K, редактирует по текстовой инструкции, принимает до десяти референсов и расставляет элементы по bounding box. Веса открыты, сборка INT8 работает на картах от 8 ГБ, а картинка в 1 МП на RTX 4070 занимает меньше девяти секунд.
Что за модель: младшая сестра FLUX 3 с открытыми весами
Black Forest Labs выпустила Klein 15 октября. Внутри те же возможности, что у полного FLUX 3 Image: текст в картинку, редактирование, мультиреференс и управление композицией. Разница в размере и цене запуска.
Параметров 5,6 млрд, и считаются они только для генератора, без текстового энкодера. Для сравнения: у Qwen-Image 2.1 их 7 млрд, у Krea 2 — 12,9 млрд. По внутренним замерам BFL модель обходит открытых конкурентов в генерации, редактировании и работе с референсами, а предыдущую FLUX.2 klein на 9 млрд — на 91 Elo при 38% меньшем размере.
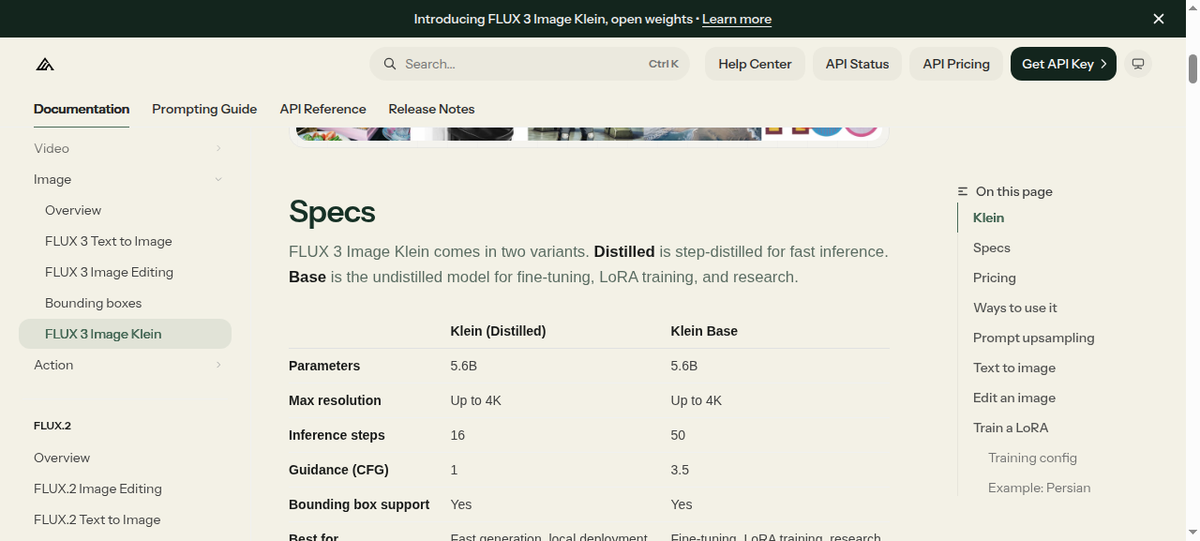
Есть две версии. Distilled — для быстрой генерации: 16 шагов, CFG 1, доступна и в API, и на Hugging Face. Base — без дистилляции: 50 шагов, CFG 3,5, нужна для дообучения, LoRA и исследований. Для обложек в продакшене берут distilled, для своего стиля — base.
Четыре возможности, которые важны для контента
Первое: нативное 4K. Картинку не апскейлят после генерации, модель сразу рисует в высоком разрешении, поэтому мелкие детали и текст на постере не превращаются в кашу при увеличении.
Второе: редактирование по инструкции. Можно попросить «убери тень под товаром» или «поменяй фон на бежевый» и сохранить остальное без изменений. Для карточек и обложек это дешевле, чем генерировать заново.
Третье: до десяти референсов. Модель удерживает стиль и персонажа по фотографиям: пригодится, когда у бренда есть визуальный гайд, а рисовать нужно много и быстро.
Четвёртое: bounding boxes. Элементы размещаются по координатам, а правки ограничиваются рамкой. Это единственный надёжный способ добиться предсказуемой композиции: заголовок слева, товар справа, логотип в углу.
Память и скорость: три сборки под разное железо
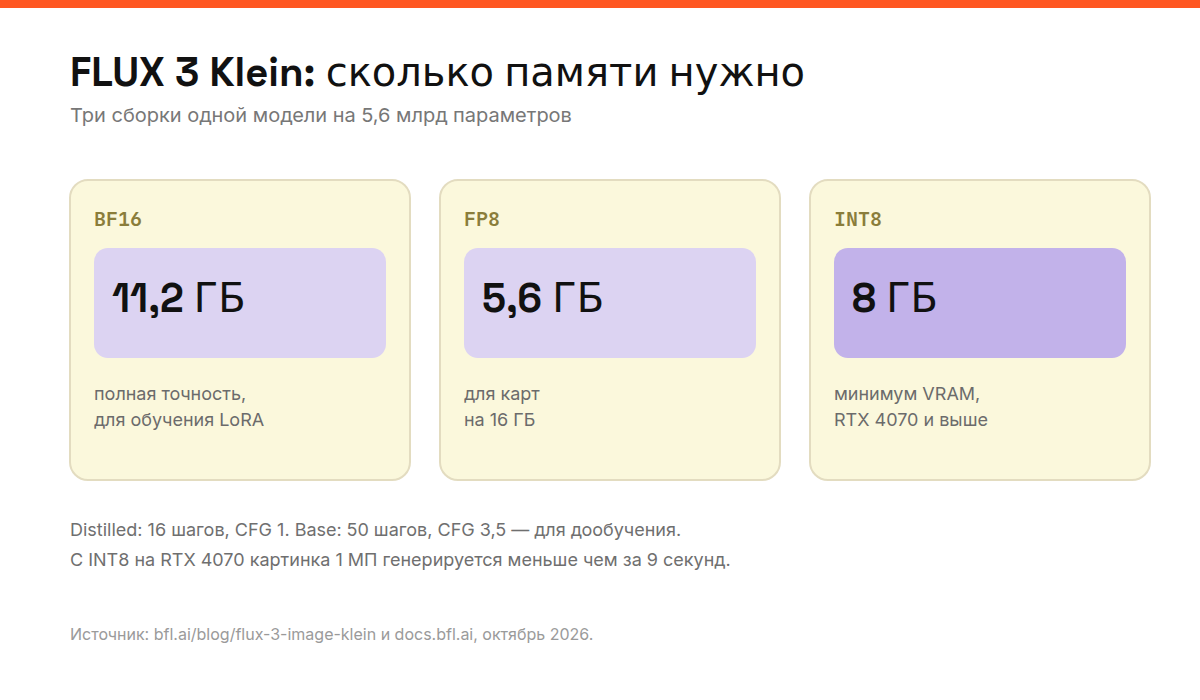
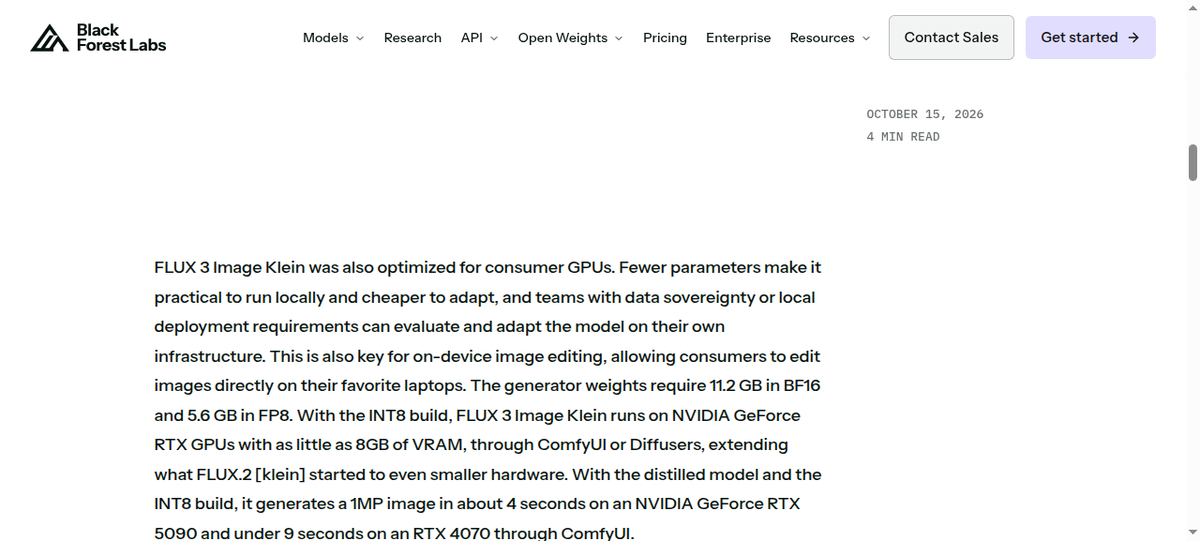
Веса генератора занимают 11,2 ГБ в BF16 и 5,6 ГБ в FP8. Сборка INT8 запускается на GeForce RTX с 8 ГБ видеопамяти через ComfyUI или Diffusers. Документация говорит, что модель работает вплоть до RTX 3090.
Скорость зависит от карты и сборки. Дистиллированная модель с INT8 рисует 1 МП примерно за 4 секунды на RTX 5090 и меньше чем за 9 секунд на RTX 4070. На серверной GB300 в NVFP4 тот же кадр занимает меньше 0,6 секунды, но это уже про ферму, а не про ноутбук.
Апсемплер промптов: без него модель работает хуже
Klein обучен на подробных описаниях сцены, а не на коротких запросах вроде «обложка для поста про кофе». Рядом с моделью идёт апсемплер flux-3-image-klein-pup: он переписывает короткий промпт или одну строку правки в полное описание и только потом отдаёт его генератору.
Документация BFL просит не использовать Klein без него. В CLI апсемплер включён по умолчанию, отключается флагом --no-pup. В Diffusers это отдельная модель: её запускают через Transformers и передают результат в пайплайн как обычный промпт. Важная деталь для слабых карт: в Diffusers апсемплер добавляет около 28 ГБ видеопамяти, поэтому на 8 ГБ его держат отдельным шагом или работают через ComfyUI.
Практический вывод: если картинки выходят «пустыми» и не слушают промпт, дело чаще всего не в модели, а в пропущенном апсемплере.
Пайплайн обложек: пять шагов до готового файла
Шаг первый: собираем визуальный бриф. Что на обложке, какой фон, какие цвета бренда, где останется место под заголовок. Модель не знает, что текст вы будете накладывать отдельно, поэтому пустую зону нужно заказывать явно, например через bounding box.
Шаг второй: пишем промпт по формуле «сцена, объект, свет, стиль, композиция». Коротко: предмет в центре, мягкий свет сбоку, тёмный фон, место слева под текст. Дальше апсемплер разворачивает это в подробное описание.
Шаг третий: генерируем в 4K с соотношением 4:5 или 1:1 под конкретную площадку. 4K нужен не для красоты: из него потом режется несколько форматов под рилс, телеграм и карточку товара без потери резкости.
Шаг четвёртый: правим точечно. Если композиция верная, а тень не та, не перегенерируем всё, а просим изменить область. Так сохраняется стиль и не тратится время.
Шаг пятый: текст и логотип. Их лучше накладывать в редакторе: генераторы до сих пор путают буквы в кириллице, а исправлять это промптом дороже, чем поставить заголовок в макете.
Свой стиль: LoRA на базовой версии
Если нужно двадцать обложек в одном стиле, промпт не спасёт: цвет уедет, свет изменится, композиция поплывёт. Правильный путь — обучить LoRA на своей подборке из 15–30 картинок. Для этого и нужна версия Base: она не дистиллирована и лучше принимает дообучение.
Из коробки работают Diffusers, AI Toolkit Остриса и рецепты NVIDIA NeMo AutoModel. Обучение идёт на своих изображениях и не требует доступа к исходным данным модели. Дальше LoRA подключается к distilled-версии, и генерация остаётся быстрой.
Отдельная выгода для агентских сценариев: LoRA можно менять как настройку. Один сервер, одна модель, разные стили под разных клиентов.
Distilled или Base — это выбор между скоростью и контролем
Distilled рисует за 16 шагов и почти не требует подстройки. Это рабочая лошадка для контента: обложки, карточки, иллюстрации к постам. Base даёт больше контроля, но требует 50 шагов и терпения, зато именно на нём обучают LoRA и проводят эксперименты.
В продакшене обычно держат обе: base для обучения и проверки идей, distilled для массовой генерации. Разница в весах невелика, а выигрыш по времени существенный.
Лицензия и API: два разных сценария
Веса выходят под FLUX Kommunity License. Использовать модель коммерчески бесплатно могут частные лица и компании с годовой выручкой до 5 млн долларов; крупным организациям нужна отдельная self-hosted лицензия. Условия стоит прочитать целиком, особенно если картинки идут в продукт клиента.
Если своё железо не нужно, есть API BFL. Цена зависит от разрешения: 768×768 — 0,008 доллара, 1K — 0,009, 1,5K — 0,011, 2K — 0,014, 4K — 0,036 за картинку. Для проверки гипотез API дешевле, чем покупка карты; для потока в сотни изображений в день своя модель окупается.
Ключи API и веса не стоит хранить в репозитории. Если картинки генерирует агент, ключ живёт в переменных окружения на сервере, а не в промпте.
Итог — это модель, которая убирает студию из процесса
FLUX 3 Klein закрывает типовую боль контентмейкера: обложки нужны каждый день, а студия и дизайнер стоят денег и времени. Открытые веса, 4K, редактирование и запуск на одной видеокарте делают производство предсказуемым: один раз настроил пайплайн, дальше он работает без внешних сервисов.
Начать стоит с малого: поставить ComfyUI, прогнать десяток обложек на distilled с апсемплером и сравнить с тем, что сейчас делается руками. Если стиль совпал, следующий шаг — LoRA на своих работах и автоматизация через API или агента.