NVIDIA выпустила три открытые модели Nemotron 3.5. Флагман Super VL — 120 млрд параметров, из которых в работе участвуют 12 млрд, контекст до миллиона токенов и работа с текстом, картинками и видео. Рядом встали две локальные: Bolt 74B-A9B, который занимает 24 ГБ памяти, и Bolt E4B на 4 ГБ. Веса, датасеты и рецепты обучения открыты, лицензия OpenMDW-1.1 разрешает коммерческое использование.
Три модели — это одна линейка, которая закрывает путь от дата-центра до ноутбука
Линейка Nemotron строится по уровням. Lightning, вышедшая в августе, отвечает за высокую пропускную способность. Ultra на 550 млрд параметров берёт самые сложные задачи рассуждения. Новая Super VL встаёт между ними по размеру, но обгоняет обе по эффективности на агентских сценариях. Bolt — отдельная ветка для края: локальные агенты на ноутбуках, рабочих станциях и встраиваемых устройствах.
Super VL и Bolt 74B-A9B уже доступны на Hugging Face. Младшая Bolt E4B на 4 ГБ выходит 23 октября. Все три модели опубликованы с открытыми весами, датасетами и рецептами обучения — это не «открытый вес без документации», а полный набор для дообучения через NVIDIA NeMo.
Ключевое отличие от закрытых моделей в том, что компания может дообучить модель на своих данных, развернуть на своей инфраструктуре и не отправлять запросы наружу. Для банков, страховых и промышленных заказчиков это часто важнее, чем несколько процентов в бенчмарках.
Super VL — это модель на 120 млрд параметров, из которых в работе участвуют 12 млрд
Архитектура гибридная: слои Mamba-2, mixture-of-experts и attention, плюс отдельный визуальный энкодер C-RADIO. Такая схема даёт скорость обычной small-модели при качестве крупной: NVIDIA заявляет, что Super VL показывает точность, сопоставимую с их самой большой reasoning-моделью Ultra на 550 млрд параметров, при примерно в пять раз меньшем числе параметров.
Контекст — до миллиона токенов. На вход модель принимает текст, изображения и видео, на выходе отдаёт текст. Для агента это значит, что она может разобрать веб-страницу, PDF с таблицами, график или скан документа и сразу перейти к действию, не передавая задачу между разными системами. Именно на OCR, таблицы, диаграммы и структурированные документы NVIDIA делает основной упор.
Обучение шло на примерно 26 трлн токенов, затем дообучение на 3,8 млн примеров и reinforcement learning в десятках сред. NVIDIA заявляет, что модель работает в пять раз быстрее ближайшего открытого конкурента в своём классе. Цифры вендорские, поэтому их стоит проверять на своих задачах, а не принимать на веру.
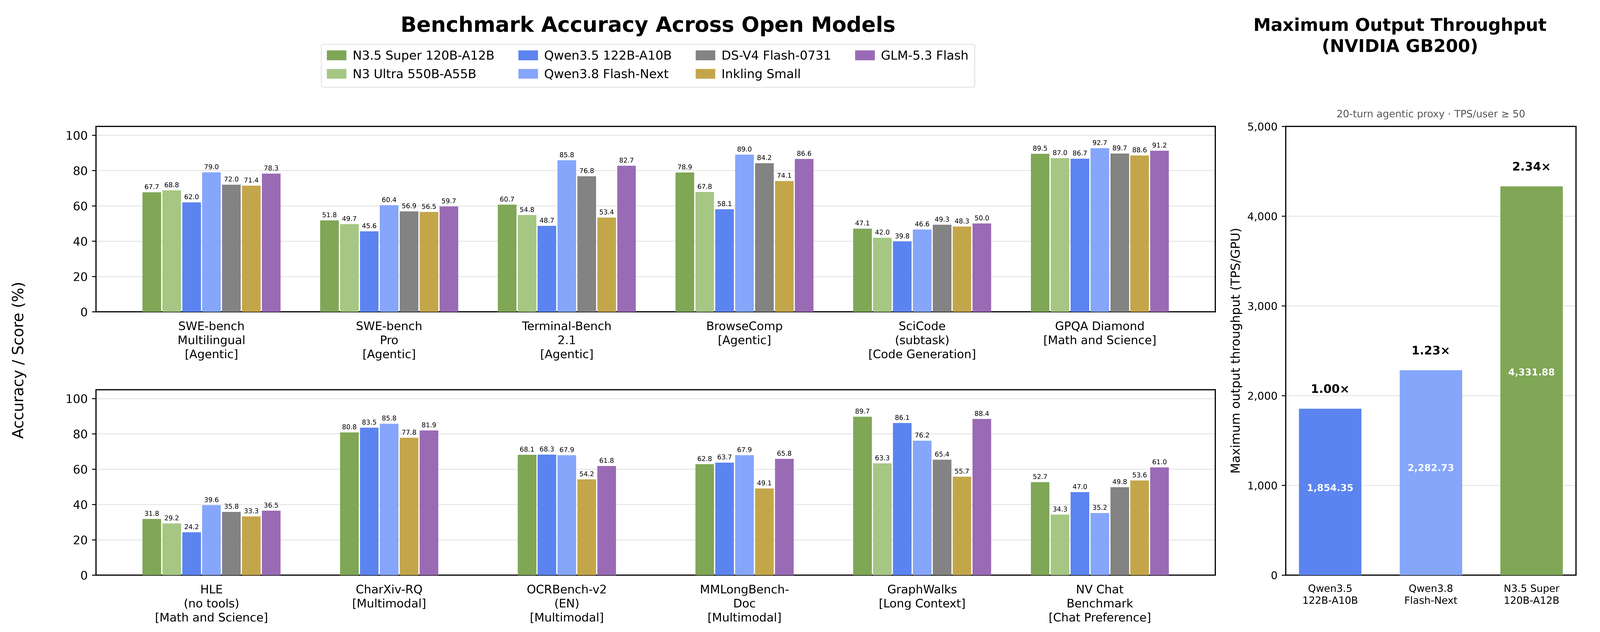
По карточке модели точность такая: GPQA-Diamond — 89,5, Terminal-Bench 2.1 — 60,7, GraphWalks — 89,7 при 63,3 у Nemotron 3 Ultra. На SWE-bench Multilingual модель чуть уступает Ultra — 67,7 против 68,8, зато заметно быстрее. То есть это не «младшая модель, которая везде хуже»: на длинных цепочках и работе с графами она сильнее крупной, а на части кодинга — ровнее.
Bolt 74B-A9B — это локальный агент, который занимает 24 ГБ памяти
Старшая из двух локальных моделей: 74 млрд параметров, 9 млрд активных, контекст до 256 тысяч токенов. Нативная двухбитная квантизация IQ2 с обучением, учитывающим квантование, позволяет уложить веса в 24 ГБ — то есть модель помещается на одну потребительскую видеокарту или на ноутбук RTX Spark и работает рядом с другими приложениями.
Заявленные задачи — многошаговое рассуждение, вызов инструментов и работа с вебом. NVIDIA называет Bolt 74B первой открытой моделью в своём классе на PinchBench и второй среди открытых на BrowseComp. Запускается она в llama.cpp, Ollama, LM Studio, Unsloth и vLLM, а для ускорения идёт с драфтером LiLiCorr и семью спекулятивными токенами.
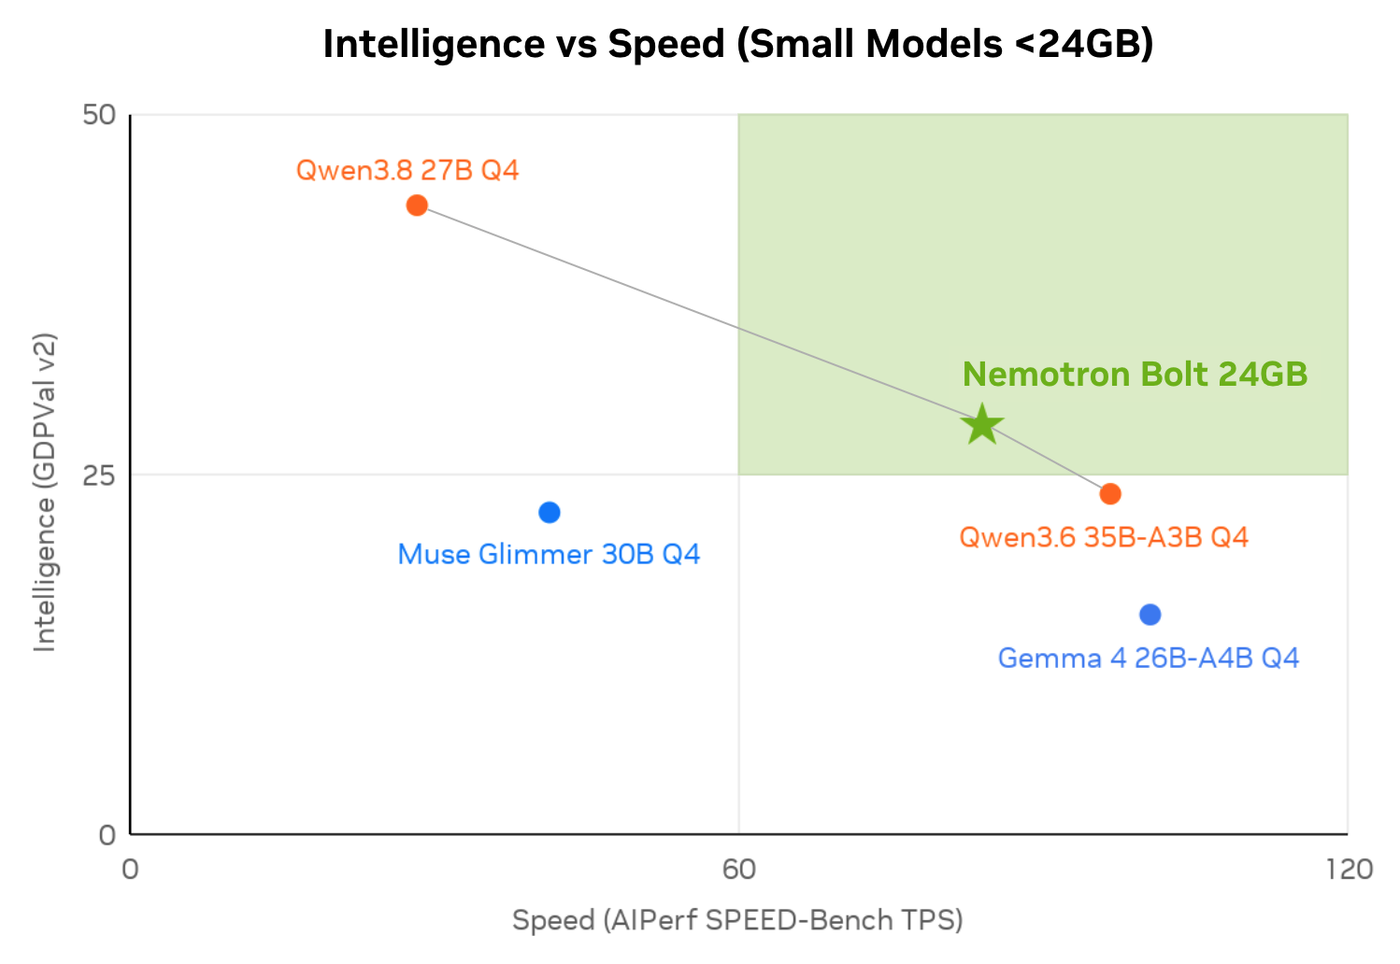
Практический смысл простой: агент, который читает веб, правит код и разбирает документы, больше не обязан ходить в облако. Данные остаются на машине, а счёт за токены не растёт вместе с числом запросов.
Bolt E4B — это 4 ГБ для разговорных и физических агентов
Младшая модель занимает 4 ГБ и рассчитана на быстрые диалоги: голосовые ассистенты, интерактивные персонажи, встраиваемые интерфейсы. Работает на GeForce RTX, Jetson и на системах RTX и DGX Spark. Выходит 23 октября, то есть на момент публикации её ещё нет в открытом доступе.
Эта модель интересна не качеством ответов на сложные задачи, а тем, что её можно поставить туда, где нет ни сервера, ни стабильного интернета: в кассовый терминал, медицинский прибор, промышленный контроллер или устройство с голосовым интерфейсом.
Что это меняет для бизнеса — это данные, которые не покидают контур
Главный аргумент открытых моделей — не цена токена, а контроль. Компания может дообучить Super VL на своих договорах, регламентах и исторических решениях, развернуть модель в своём дата-центре и не заключать соглашение о передаче данных третьей стороне. Для страховой, банка или юридической фирмы это часто единственный способ вообще запустить агента на чувствительных документах.
В анонсе NVIDIA перечисляет реальных заказчиков и подрядчиков: Scale AI дообучает модель для агента Skydance по вендорским кредитам и для EY по M&A due diligence, CrowdStrike — для защиты в корпоративной безопасности, Ramp — для финансовых документов, R1 — для разбора медицинских страховых случаев. Perplexity, Salesforce, Atlassian и Dassault Systèmes встраивают модель в свои продукты.
Обратная сторона тоже честная: открытая модель — это не кнопка. Нужны GPU, люди, которые умеют её развернуть и обновлять, и своя ответственность за качество. Экономия на подписке легко съедается стоимостью железа и инженерного времени, если нагрузка небольшая.
На чём запускать — это от 4 ГБ на ноутбуке до четырёх H100 в дата-центре
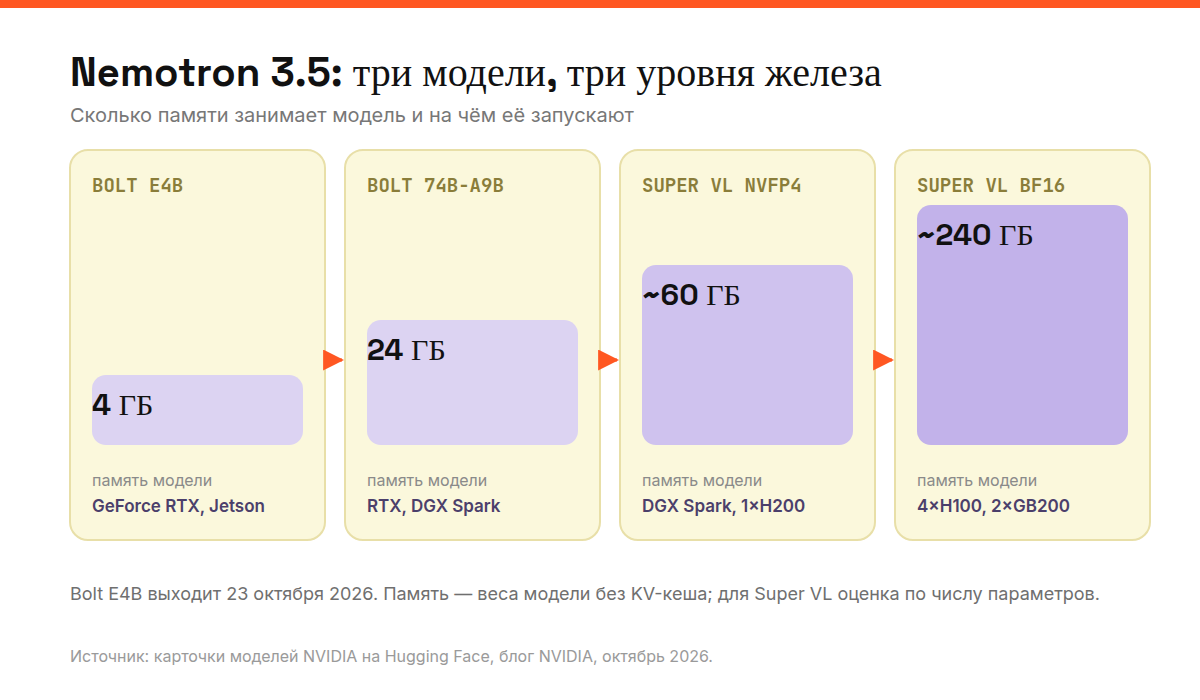
Требования к железу различаются в десятки раз, и это главный критерий выбора. Полноточная версия Super VL в BF16 занимает около 240 ГБ и разворачивается на четырёх H100 или двух GB200. Квантованная NVFP4 — примерно вчетверо компактнее: её можно поднять на одной DGX Spark, одном H200, двух H100 или одном GB200.
| Модель | Параметры | Контекст | Память | Железо |
|---|---|---|---|---|
| Bolt E4B | — | — | 4 ГБ | GeForce RTX, Jetson |
| Bolt 74B-A9B | 74B (9B) | 256K | 24 ГБ | RTX, DGX Spark |
| Super VL NVFP4 | 120B (12B) | 1M | около 60 ГБ | DGX Spark, H200, 2×H100, GB200 |
| Super VL BF16 | 120B (12B) | 1M | около 240 ГБ | 4×H100, 2×GB200 |
Для продакшена есть два ускорителя. NVIDIA NIM упаковывает модель в микросервис с проверенными конфигурациями и обновлениями безопасности раз в две недели. NVIDIA Dynamo при обслуживании позволяет держать до восьми раз больше пользователей при снижении задержки на 85% — это уже про экономику большого потока, а не про один пилот.
Лицензия и риски — это OpenMDW-1.1, шесть языков и своя ответственность
Модели выходят под лицензией OpenMDW-1.1: коммерческое использование разрешено, веса и датасеты открыты. Но это не Apache 2.0 — условия стоит прочитать юристу, особенно если модель встраивается в продукт, который продаётся клиентам.
Второе ограничение — языки. В карточке перечислены английский, испанский, французский, немецкий, итальянский и японский. Русского в списке нет. Это не значит, что модель не понимает русский совсем, но качество на русских документах нужно измерять на своих данных, а не переносить результаты английских бенчмарков. Для русского агента почти наверняка понадобится дообучение.
Третье — квантование. Bolt ужат до двух бит, и это компромисс: на части задач качество просядет по сравнению с BF16-версией. Проверять надо именно тот формат, который пойдёт в продакшен, а не полноточную версию из карточки.
Четвёртое — вендорские цифры. Пять раз быстрее, первое место на PinchBench, паритет с Ultra — это заявления NVIDIA на своих сценариях. Хорошая практика — прогнать 100–200 реальных задач из своего процесса и сравнить с текущей моделью, прежде чем строить на этом решение.
Как выбрать — это три вопроса про железо, данные и задачу
Первый вопрос — где будет работать агент. Если на ноутбуке или устройстве без облака, выбор заканчивается на Bolt. Если в дата-центре и с большими документами, нужен Super VL. Для голосового интерфейса на слабом железе — E4B.
Второй — какие данные. Если документы чувствительные и не могут покидать контур, открытая модель с локальным развёртыванием решает задачу, которую закрытый API решить не может. Если данные не критичны, дешевле и быстрее может оказаться облачная модель — считать надо по совокупной стоимости.
Третий — какая задача. Для разбора PDF, таблиц и сканов Super VL закрывает весь путь: увидел, прочитал, извлёк, ответил. Для агента, который ходит по сайтам и вызывает инструменты, хватает Bolt. Для диалога и голоса — E4B.
Начинать стоит с одного процесса и двух недель замера: точность на своих данных, скорость ответа, стоимость часа работы железа. Открытые модели дают контроль, но не отменяют пилот.
Итог — это открытая модель, которая впервые закрывает весь путь от сервера до ноутбука
Nemotron 3.5 — не одна модель, а линейка из трёх уровней, и это её главная ценность. Компания выбирает не «самую умную модель вообще», а ту, что помещается на её железо и закрывает её задачу: 4 ГБ для голоса, 24 ГБ для локального агента, серверный Super VL для документов и мультимодальных сценариев.
Для рынка это означает, что открытые модели добрались до уровня, где их можно обсуждать не как эксперимент, а как продакшен-вариант. Ограничения при этом остаются: русский язык, ответственность за качество и стоимость железа никуда не делись.