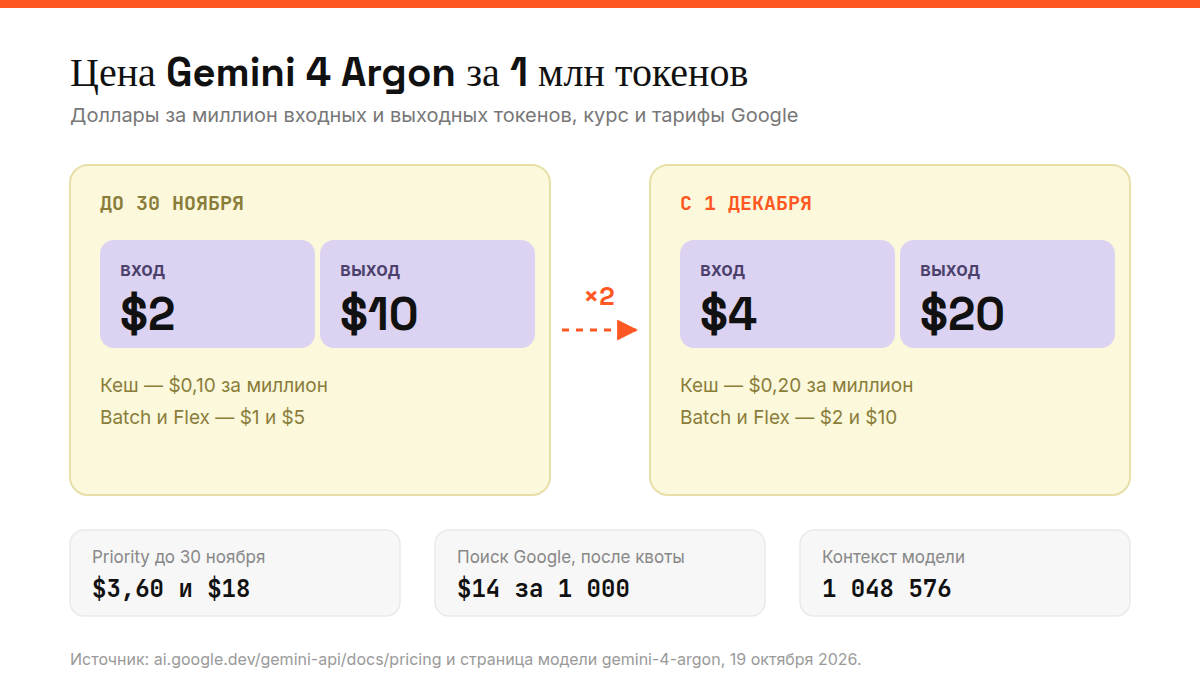
Gemini 4 Argon открылась в платном API и в чате на тарифах Pro и Ultra. До 30 ноября вход стоит $2, выход $10 за миллион токенов, с 1 декабря — $4 и $20. Модель понимает текст, картинки, видео, аудио и PDF, держит в контексте миллион токенов и умеет отдавать ответ длиной до миллиона токенов в режиме long decode.
Gemini 4 Argon — это флагманская reasoning-модель Google, которая работает с контекстом в миллион токенов
В документации модель называется gemini-4-argon и имеет статус stable — то есть версия зафиксирована и не будет молча меняться под работающим агентом. Это важно для продакшена: обновление модели не должно ломать промпты и форматы ответа без вашего ведома.
Контекст в 1 048 576 токенов общий для входа и выхода. Обычный синхронный ответ ограничен 65 536 токенами, но есть long decode — режим, в котором выход растягивается до миллиона токенов. На практике это означает, что модель может переписать целый кодовая база или собрать большой документ за один вызов, а не за десять.
На вход модель принимает текст, изображения, видео, аудио и PDF, на выходе отдаёт только текст. Генерации картинок и Live API у неё нет — для этого в линейке есть отдельные модели. Размышления включаются на трёх уровнях: low, medium и high. Чем выше уровень, тем больше токенов модель тратит на рассуждение и тем дороже выходит ответ.
Из инструментов поддерживаются вызов функций, структурированный вывод, поиск Google, карты, файловый поиск, URL-контекст, исполнение кода и computer use в превью. Для агента это готовый набор: поиск и карты подключаются без отдельного провайдера, а действия в браузере можно отдавать computer use.
Цена — это $2 за вход и $10 за выход до 30 ноября, дальше вдвое больше
Google держит стартовую цену на уровне топовых моделей конкурентов: $2 за миллион входных и $10 за миллион выходных токенов. Это временная ставка — она действует до 30 ноября 2026 года включительно. С 1 декабря вход стоит $4, выход $20, то есть счёт вырастет ровно в два раза при том же объёме работы.
В цену выхода уже входят токены размышлений. Если включить thinking на high и попросить модель подумать подольше, вы платите не только за финальный текст, но и за весь ход рассуждения. Поэтому уровень размышлений — это не только вопрос качества, но и статья бюджета.
| Режим | Вход, $/1 млн | Выход, $/1 млн |
|---|---|---|
| Standard до 30.11 | $2 | $10 |
| Standard с 01.12 | $4 | $20 |
| Batch и Flex | $1 | $5 |
| Priority до 30.11 | $3,60 | $18 |
Бесплатного тарифа у Argon нет: в прайсе прямо указано, что модель недоступна на free tier. Это отличает её от Flash-моделей, у которых есть бесплатные лимиты. Для агента с постоянной нагрузкой это значит, что бюджет нужно закладывать с первого дня, а не «потом, когда пойдёт трафик».
Кеш — это скидка 95%, которая включается сама, но только для повторяющегося начала промпта
Кешированный вход стоит $0,10 за миллион вместо $2 — в двадцать раз дешевле. Но у Argon работает только неявный кеш: отдельно создавать и управлять кешем нельзя, Google сам замечает одинаковое начало запроса и тарифицирует его по льготной ставке. С 1 декабря цена кеша вырастет до $0,20.
Чтобы попасть в кеш, промпт нужно строить сверху вниз: сначала системная инструкция, потом описания инструментов, потом база знаний или документы, и только в конце — вопрос пользователя. Всё, что меняется от запроса к запросу, должно быть в хвосте. Если тасовать блоки местами, кеш не сработает и вы будете платить полную цену за каждый вызов.
Экономия ощутима на агентах с большим системным промптом и повторяющимся контекстом. При 60% закешированного входа тот же объём работы дешевеет примерно на четверть: в расчёте ниже это $105,80 вместо $140 до 1 декабря.
Batch и Flex — это те же модели за полцены, если ответ не нужен сию секунду
Batch API даёт 50% скидки в обмен на отложенную выдачу: задания ставятся в очередь, результат приходит в течение суток. Для Argon это $1 за вход и $5 за выход. Подходит для ночных прогонов, массовой обработки документов, разметки и генерации контента, где важна цена, а не секунды.
Flex — режим с той же ценой $1 и $5 для задач, которые допускают паузу в обслуживании. Priority — наоборот, ускоренная очередь с наценкой: $3,60 за вход и $18 за выход до 1 декабря. Его имеет смысл включать только там, где задержка стоит дороже наценки: в клиентской поддержке, голосовых сценариях, интерактивных интерфейсах.
Практический вывод простой: если задача терпит сутки, платить полную цену незачем. Разница между стандартным и batch-режимом по бюджету такая же, как разница до и после 1 декабря, только её можно получить уже сегодня.
Поиск и карты — это отдельный счёт, который может оказаться дороже токенов
Grounding с Google Search стоит $14 за тысячу запросов. Каждый месяц даётся 5 000 бесплатных поисковых запросов, но лимит общий для всех моделей Gemini 3 и новее — если вы уже расходуете его на Flash, Argon останется без бесплатной квоты. С картами та же история: 5 000 бесплатных запросов в месяц, дальше $14 за тысячу.
Тонкость в том, что один запрос к модели может породить несколько поисковых запросов, и каждый тарифицируется отдельно. Ориентир: 10 000 обращений к агенту с поиском — это 5 000 платных запросов и $70 только за поиск, при том что сами токены обойдутся в $140. Поиск здесь не «мелкая доплата», а сопоставимая статья расходов.
Поэтому поиск стоит включать по условию: когда вопрос требует свежих данных, а не всегда. Агент, который ищет в интернете на каждый «привет», сжигает бюджет быстрее, чем работает.
Расчёт — это арифметика на 10 000 запросов, где разница до и после 1 декабря видна сразу
Возьмём типичную нагрузку: 10 000 запросов в месяц, в каждом 3 000 входных и 800 выходных токенов. Это 30 миллионов входных и 8 миллионов выходных токенов. По курсу Центробанка на 17 октября 2026 года — 83,62 рубля за доллар.
| Статья | До 30.11 | С 01.12 |
|---|---|---|
| 30 млн входных токенов | $60 | $120 |
| 8 млн выходных токенов | $80 | $160 |
| Итого в месяц | $140 (11 700 ₽) | $280 (23 400 ₽) |
| С кешем 60% входа | $105,80 (8 850 ₽) | $211,60 (17 700 ₽) |
| В режиме Batch | $70 (5 850 ₽) | $140 (11 700 ₽) |
Видно, что кеш экономит около четверти счёта, а batch — половину. Если сложить оба приёма, 10 000 запросов в batch с прогретым кешем обойдутся примерно в $52,90 до 1 декабря — это меньше, чем $60, которые вы заплатили бы только за входные токены по стандартному тарифу.
Эти цифры — ориентир, а не точный прогноз: реальный расход зависит от длины системного промпта, уровня размышлений и того, как часто агент обращается к поиску. Считать нужно по своим логам, а не по средним значениям из статьи.
Argon против Flash — это разница в 2,7 раза по цене и в классе задач
Gemini 3.8 Flash стоит $0,75 за вход и $3,75 за выход — ровно в 2,7 раза дешевле Argon по обеим позициям. Для рутины этого достаточно: извлечение полей из документов, классификация обращений, короткие ответы по базе знаний, суммаризация. Flash справляется с этим быстрее и дешевле.
Argon нужен там, где Flash начинает ошибаться: длинные цепочки рассуждений, агенты с несколькими инструментами, разбор больших PDF и видео, генерация кода на миллион токенов. Если задача требует, чтобы модель держала в голове весь договор на 300 страниц и при этом планировала действия, экономия на Flash обернётся переделками.
Разумная схема для агента — маршрутизация: простые запросы уходят в Flash, сложные и дорогие по последствиям ошибки — в Argon. На практике это обычно снижает бюджет на 60–70% без потери качества на ключевых сценариях. В batch-режиме Argon стоит $1 и $5 — всего на треть дороже стандартного Flash, и это уже другой разговор о цене.
Что сделать до 1 декабря — это пять шагов, которые сохранят бюджет
Первое: замерить реальные токены на своих сценариях. Не по документации, а по логам — вход, выход, доля повторяющегося префикса. Без этих цифр любой расчёт остаётся догадкой.
Второе: перестроить промпты под неявный кеш. Стабильная часть — в начало, переменная — в конец. Это бесплатная оптимизация, которая не требует смены модели.
Третье: перевести всё, что терпит сутки, в Batch. Ночные прогоны, отчёты, массовая обработка документов — там скидка 50% достаётся почти без усилий.
Четвёртое: поставить ограничение на thinking. Уровень high включать только для задач, где он реально меняет результат, а не по умолчанию для всех запросов.
Пятое: зафиксировать версию модели в конфиге — gemini-4-argon, а не плавающий алиас. И заложить в бюджет удвоение цены с 1 декабря: если пилот стартует в ноябре, его экономика в декабре будет другой.
Итог — это окно в шесть недель, когда флагманская модель стоит как средняя
Argon даёт то, чего не хватало линейке: миллион токенов контекста, длинную генерацию, нормальное планирование в агентских сценариях и работу с видео и аудио. Цена на старте — $2 и $10, что для флагмана довольно скромно, но окно закрывается 30 ноября.
Для бизнеса это означает простую вещь: считать экономику внедрения нужно на декабрьских ценах, а не на стартовых. Если сценарий окупается при $4 и $20 — его можно запускать. Если только при $2 и $10 — это пилот на полтора месяца, а не продукт.