DeepSeek добавила в свой API два инструмента: Search ищет по вебу и отдаёт до 50 результатов с готовыми выжимками, Fetch забирает страницу и возвращает её в Markdown. Оба стоят $0,75 за тысячу успешных вызовов — около 6 копеек за запрос, а пустые ответы не тарифицируются. Для агента это значит, что отдельная подписка на поиск и парсер больше не обязательна.
Search API — это поисковый движок, который отдаёт результаты в готовом для модели виде
Search работает по адресу POST https://api.deepseek.com/v1/tools/search и авторизуется тем же ключом, что и обычные запросы к модели. В ответ приходит не страница с ссылками, а массив объектов: заголовок, адрес, короткий сниппет, длинная выжимка и оценка источника. Агенту не нужно разбирать вёрстку — он сразу получает текст, который можно положить в контекст.
| Поле запроса | Что делает |
|---|---|
query | Поисковая фраза от 1 до 128 символов, поддерживает операторы |
count | Сколько результатов вернуть: от 1 до 50, по умолчанию 10 |
ori_question | Исходный вопрос пользователя — помогает понять запрос |
localization | IP-адрес, по которому локализуется выдача |
need_content | Вернуть ли полный текст страницы в поле content |
Операторы знакомы тем, кто работал с обычным поиском: site: ограничивает домен, -site: исключает, минус перед словом убирает слово, кавычки ищут точную фразу, lang: задаёт язык, after: и before: — дату публикации. Например, запрос DeepSeek site:github.com OR site:huggingface.co lang:en after:2025 вернёт только англоязычные страницы с этих двух доменов, опубликованные после 2025 года.
В каждом результате есть два важных числа. rerank_score от 0 до 3 показывает совокупное качество: релевантность, авторитетность и свежесть, всё выше 1,5 считается хорошим результатом. authority от 0 до 4 — уровень доверия к источнику, значения 3 и выше означают авторитетный сайт. Эти два поля дают агенту то, чего у обычного поиска нет: возможность отбросить мусор до того, как он попал в контекст модели.
Поле summary — выжимка на 600–800 символов, написанная специально для модели. Это дешевле, чем читать всю страницу: десять выжимок занимают примерно 2–3 тысячи токенов вместо десятков тысяч. Полный текст в content приходит только при need_content: true и только если он доступен.
Fetch API — это загрузка страницы, которая возвращает текст в Markdown
Fetch вызывается по адресу POST https://api.deepseek.com/v1/tools/fetch и принимает единственное поле url: адрес до 8 192 символов, обязательно HTTP или HTTPS, без логина и пароля внутри ссылки. В ответ приходят заголовок страницы и содержимое в Markdown — без навигации, скриптов и рекламы.
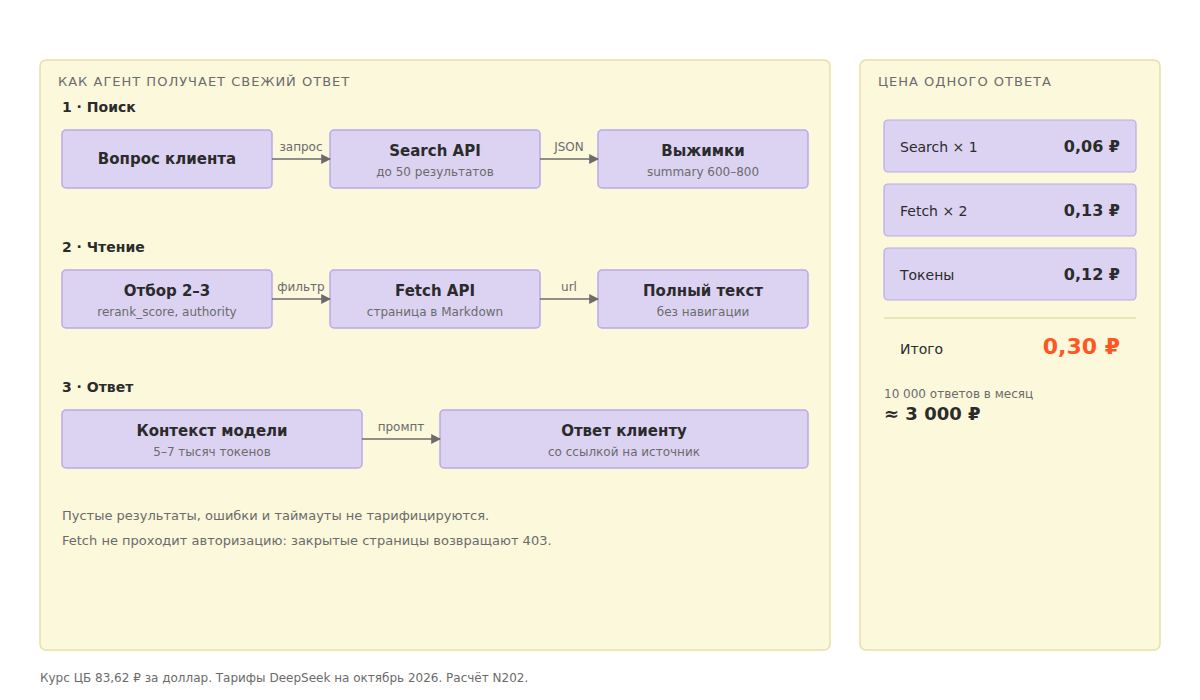
Типовой сценарий такой: Search находит кандидатов, агент отбирает два-три по rerank_score и authority, затем Fetch забирает их целиком. Такой подход дешевле, чем сразу тянуть десять страниц, и точнее, чем отвечать по одним сниппетам.
Важное ограничение: Fetch не авторизуется на сайтах и не выполняет сложные сценарии на JavaScript. Если страница закрыта логином, отдаёт контент только после прокрутки или запрещает автоматический доступ, вернётся ошибка 403 или 404. Это не сбой, а правила сайта — обходить их не нужно и нельзя.
Цена — это фиксированные $0,75 за тысячу успешных вызовов, а не оплата токенов
Оба инструмента тарифицируются одинаково: 0,75 доллара за тысячу успешных запросов. По курсу Центробанка на 17 октября 2026 года это 62,7 рубля за тысячу, то есть около 6 копеек за один вызов. Число результатов в ответе на цену не влияет: десять ссылок или пятьдесят — плата одна.
Платный только успех. Запрос тарифицируется, если вернулся HTTP 200 и непустой результат: для Search это хотя бы один элемент в массиве, для Fetch — непустое содержимое страницы. Пустая выдача, ошибки, таймауты и ответы 403 не списывают деньги. Для агента это удобно: неудачные попытки не съедают бюджет.
| Сервис | Цена за 1 000 запросов | Что отдаёт |
|---|---|---|
| DeepSeek Search | $0,75 (~63 ₽) | До 50 результатов с выжимками |
| DeepSeek Fetch | $0,75 (~63 ₽) | Страница в Markdown |
| Serper | $1,00 на стартовом пакете | Выдача Google, до 10 результатов |
| SerpAPI | от $10 на тарифе Production | Выдача Google, расширенные параметры |
Цифры конкурентов взяты из их публичных тарифов на октябрь 2026 года: Serper продаёт пакеты от 50 тысяч запросов, SerpAPI считает по подписке. Сравнение честное только по цене за запрос: у Google-провайдеров другая выдача, другие лимиты и другая глубина истории.
Стоимость одного ответа агента складывается из вызовов и токенов. Если на вопрос уходит один Search, два Fetch и около 6 800 токенов, получается около 0,30 рубля: 19 копеек за три вызова и 12 копеек за работу модели. Десять тысяч таких ответов в месяц — около 3 000 рублей. Для сравнения: один поисковый вызов стоит примерно столько же, сколько 5 000 входных токенов DeepSeek Flash, поэтому экономить на поиске в ущерб качеству обычно невыгодно.
Лимиты — это 100 и 25 запросов в секунду, которые считаются на весь аккаунт
Ограничения у Search и Fetch независимые. На аккаунт приходится 100 запросов в секунду к Search и 25 к Fetch, причём лимит общий для всех ключей: создать десять ключей и обойти его не получится. Дополнительно у Fetch есть ограничение на домен — если тянуть сотни страниц с одного сайта, часть запросов получит 429.
Для одного агента или небольшой поддержки это много: 100 запросов в секунду — это 6 000 в минуту. Узким местом почти всегда становится не лимит, а качество выдачи и стоимость полного цикла. Если агент упирается в 429, помогает не новый ключ, а очередь с повторами и уважение к чужому домену.
Для агента это замена отдельной подписке на поиск и парсер
До сих пор поиск и чтение страниц собирались из двух-трёх сервисов: один отдавал выдачу, второй превращал страницы в текст, третий чистил и резал контент. Каждый со своим ключом, счётом и лимитами. Теперь оба шага живут на том же ключе, что и модель, а выжимки уже подготовлены под контекст.
Практическая польза видна в сценариях, где данные меняются каждую неделю: цены поставщиков, наличие товара, условия доставки, изменения в законах и тарифах. Агент поддержки с поиском отвечает по актуальной странице, а не по документу, проиндексированному полгода назад. Для базы знаний это не замена, а дополнение: внутренние регламенты остаются в RAG, внешние факты приходят из Search.
Есть и обратная сторона: поиск не знает ваших правил. Если агенту разрешено отвечать клиентам, ему нужны фильтры по авторитетности, дате и домену, а также правило «нет подтверждения — передать человеку». Без этого свежесть данных не помогает, а вредит.
Риски — это качество источников и права на контент, которые остаются на вашей стороне
Поиск возвращает то, что нашёл, а не то, что правильно. Оценки rerank_score и authority помогают отсеять слабые страницы, но не гарантируют факт. Для цен, сроков и юридических условий правило простое: ответ считается подтверждённым, только если факт есть в полном тексте после Fetch, а не в коротком сниппете.
Второй риск — права. Fetch отдаёт содержимое страницы в Markdown, но это не значит, что его можно публиковать целиком. Цитировать стоит короткими фрагментами со ссылкой на источник, а массовую перепечатку чужих статей лучше не строить вообще: это нарушает права правообладателя и портит репутацию.
Третий — закрытые сайты. Часть источников отвечает 403 или 404, и это нормально: у них может быть запрет на автоматический доступ. Правильная реакция — пропустить источник, а не искать обход. Если критичный факт доступен только за логином, его должен проверить человек.
Четвёртый — качество модели на длинном контексте. Десять выжимок по 800 символов — это уже 8 тысяч знаков, и модель может потерять главное. Ограничение в три-пять источников на вопрос обычно даёт лучший ответ, чем максимальные пятьдесят результатов.
Подключение — это два HTTP-запроса на том же ключе, что и модель
Минимальная проверка занимает пару минут. Ниже пример на Python: сначала поиск, затем чтение первой подходящей страницы. Ключ берётся тот же, что для чата.
import os, requests

KEY = os.environ["DEEPSEEK_API_KEY"]
HEADERS = {"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"}

search = requests.post(
    "https://api.deepseek.com/v1/tools/search",
    headers=HEADERS,
    json={"query": "DeepSeek Search API", "count": 5, "need_content": False},
).json()

for item in search["results"]:
    print(item["title"], item["authority"], item["url"])

page = requests.post(
    "https://api.deepseek.com/v1/tools/fetch",
    headers=HEADERS,
    json={"url": search["results"][0]["url"]},
).json()

print(page["title"])
print(page["content"][:500])
Дальше результат вставляется в контекст модели как обычный текст. Если строите агента на n8n, оба вызова делаются HTTP-нодой с тем же ключом; если на LangGraph — оборачиваются в инструмент, который модель вызывает по описанию. Отдельный SDK не нужен: API обычный JSON.
Итог — это три цифры и один сценарий, с которого стоит начать
Цифры простые: 6 копеек за вызов, 30 копеек за полный ответ агента, около 3 000 рублей на десять тысяч ответов. Начать стоит с одного сценария — ответы по свежим внешним данным там, где внутренней базы знаний недостаточно: цены, наличие, условия, изменения на рынке.
Главное решение здесь не техническое, а управленческое: какие источники агент считает доверенными и что он делает, когда подтверждения нет. Если на этот вопрос есть ответ, Search и Fetch экономят и время разработки, и деньги на подписках.