Mercury 3 от Inception Labs это диффузионная языковая модель: она не пишет токен за токеном, а уточняет черновик всего ответа. Заявлено 1 068 токенов в секунду, контекст 1 миллион и цена $0,10 за миллион входных токенов на старте. Качество выше GPT-6 Luna и Claude Haiku 5.5 в 8 тестах из 12, но не во всех.
Inception Labs 19 октября выпустила Mercury 3 и заявила, что это самая способная диффузионная языковая модель из существующих. Громкая формулировка, но за ней стоит проверяемая вещь: модель генерирует текст не слово за словом, а параллельно, и на этом выигрывает там, где агент ждёт ответа на каждом шаге.
Вот что важно понять до того, как нести её в прод.
Что объявили
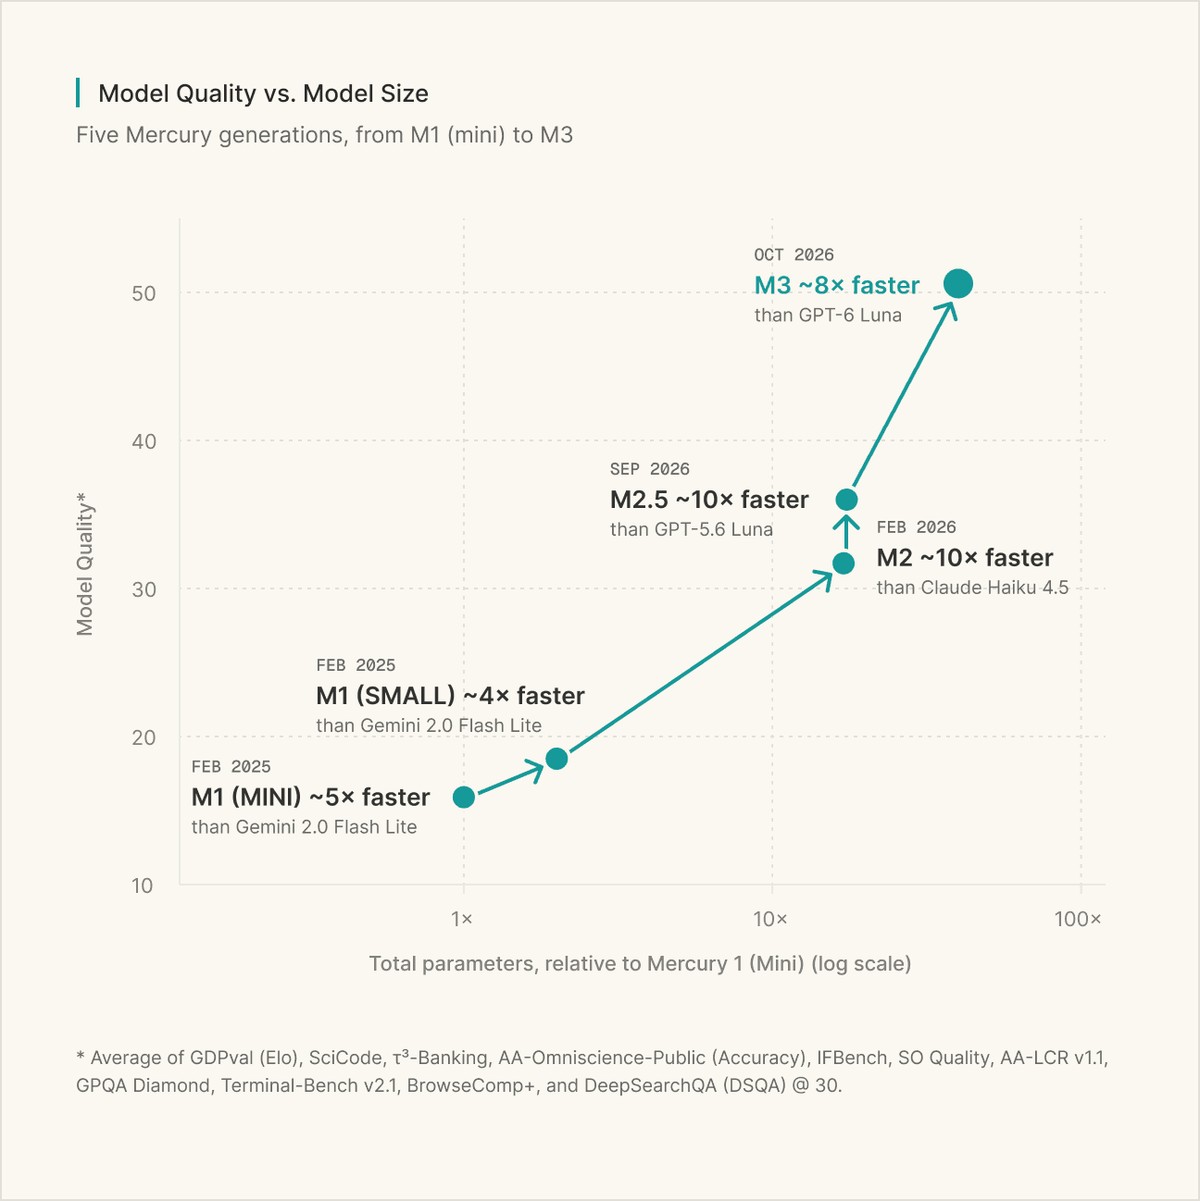
Mercury 3 это четвёртая модель Inception после Mercury 1, 2 и 2.5. Компания утверждает, что новая версия более чем в 40 раз крупнее первой и при этом работает с той же скоростью.
Заявленные характеристики из анонса:
- скорость 1 068 токенов в секунду на серийных GPU NVIDIA;
- контекст 1 миллион токенов против 260 тысяч у Mercury 2.5;
- цена $0,20 за миллион входных и $0,70 за миллион выходных;
- на старте скидка 50%, то есть $0,10 и $0,35;
- кешированные входные токены дешевле на 90%.
Доступна через API Inception, а также на OpenRouter, Baseten и Vercel. API совместим с OpenAI, поэтому переезд не требует переписывать код.
Почему диффузия быстрее
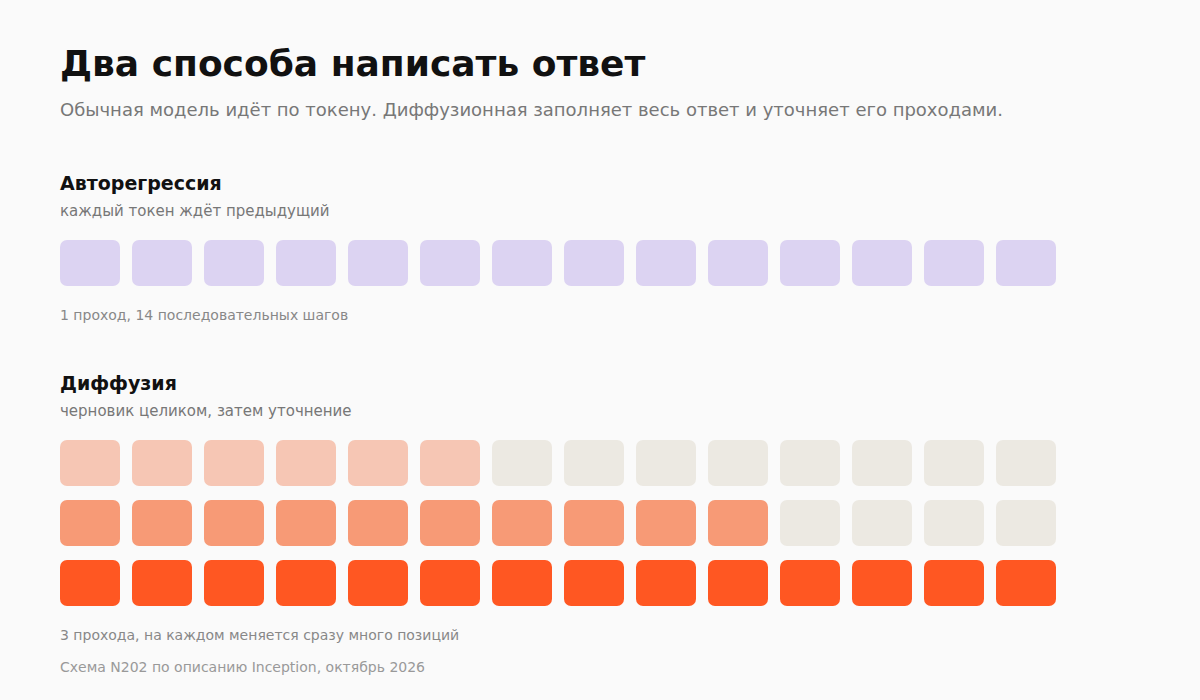
Обычная модель пишет последовательно: каждый следующий токен зависит от предыдущего. Диффузионная начинает с черновика всего ответа и несколько раз его уточняет, меняя сразу много фрагментов.
Проще говоря, она не набирает текст, а лепит и перелепливает. На картинках этот подход давно основной, в тексте он редкий, и Inception одна из немногих, кто довёл его до коммерческого продукта.
Отсюда и скорость. Но отсюда же и ограничение: качество зависит от того, сколько проходов уточнения модель делает и насколько хорошо она умеет не разваливать длинные зависимости.
Что с качеством
Здесь начинается самое интересное, потому что цифры в анонсе и цифры в таблице бенчмарков рассказывают немного разные истории.
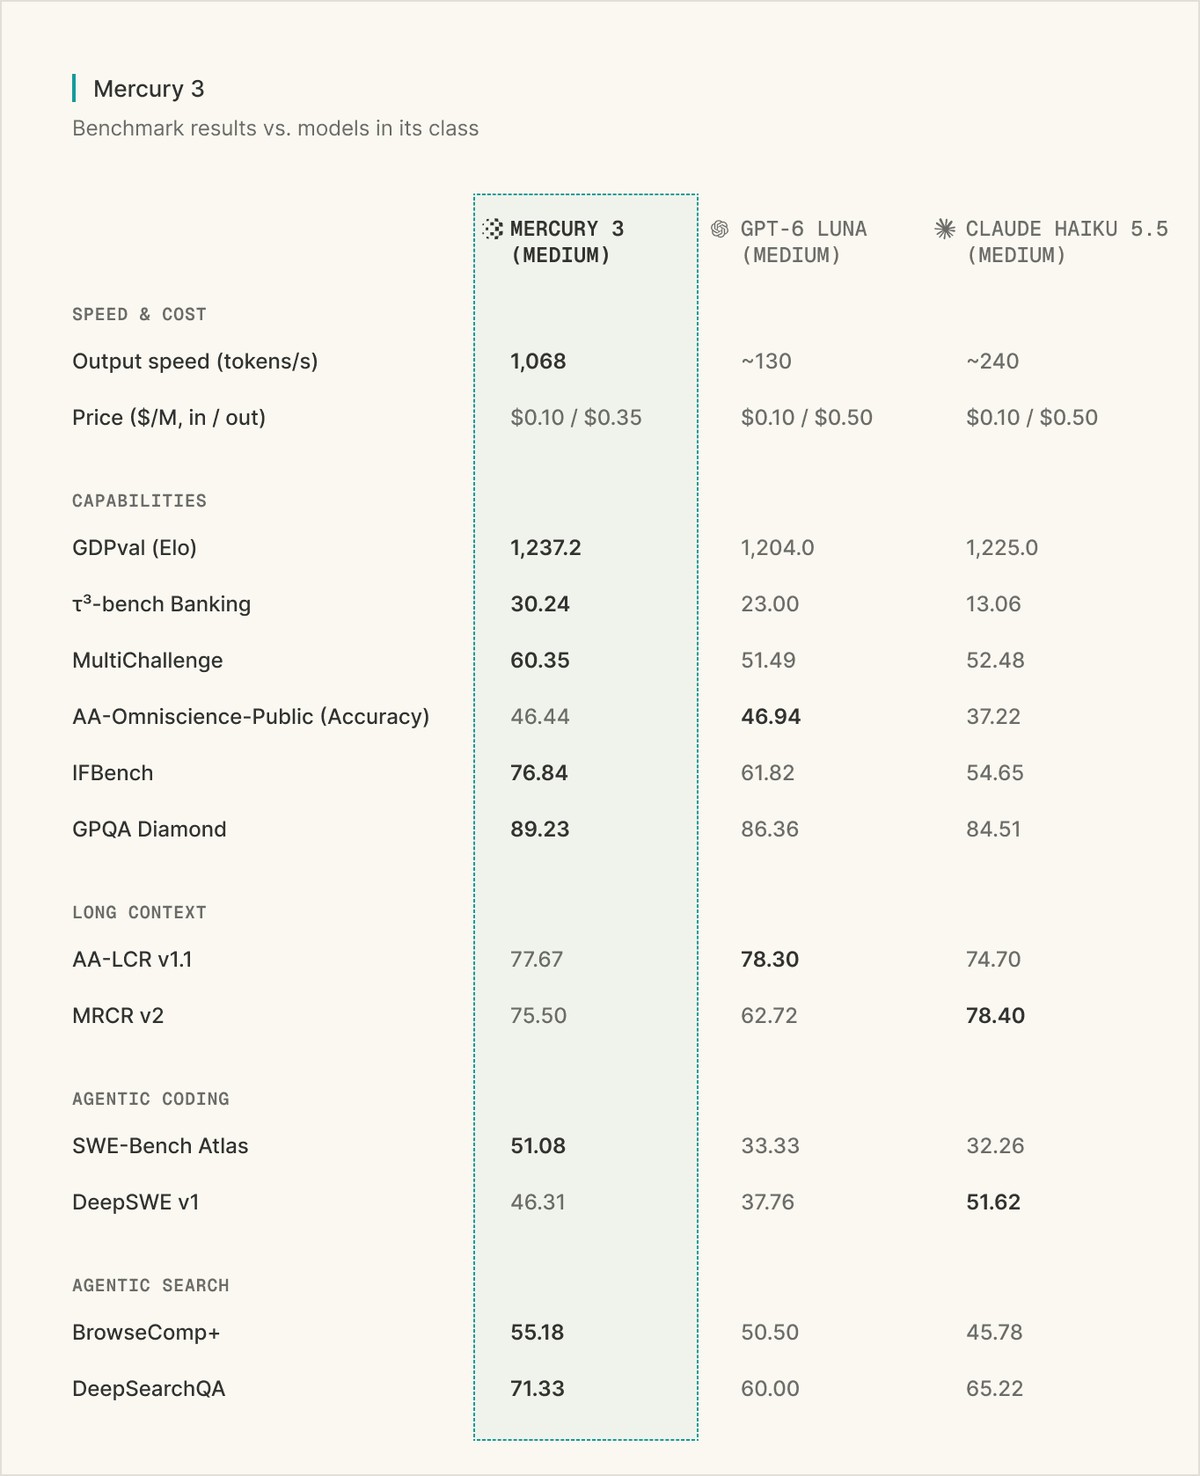
Mercury 3 выигрывает 8 тестов из 12 у GPT-6 Luna и Claude Haiku 5.5 при средних настройках. Самый большой отрыв в следовании инструкциям: IFBench 76,84 против примерно 62 у Luna. В автономном кодинге на SWE-Bench Atlas 51,08 против 33,33 и 32,26. В таблице анонса есть и другие цифры: GPQA Diamond 89,23, агентные задачи τ³ 30,24, BrowseComp+ 55,18 и DeepSearchQA 71,33.
При этом Haiku 5.5 забирает DeepSWE и лучше ищет информацию в длинных текстах. Luna выигрывает два теста Artificial Analysis. Разбор The Decoder прямо говорит: лидерство уже, чем звучит в пресс-релизе.
Это нормально. Модель, которая быстрее в четыре-восемь раз и при этом местами проигрывает, всё равно может быть выгоднее. Вопрос только в том, на каких задачах.
Где она действительно выигрывает
Inception собрала отзывы партнёров, и они полезнее бенчмарков.
TinyFish AI дала модели 50 живых задач навигации по сайтам. Mercury 3 решила половину, это больше, чем у GPT-6.1-Sol, при том же объёме токенов и том же числе шагов агента.
Octen AI делает поиск для умных очков. Поиск занимал около 80 мс, а узким местом была генерация. С Mercury 3 медиана генерации составила 0,9 секунды, полный ответ 2,2 секунды.
RevisionDojo использует модель в обучении: подсказки и разметка ответов приходят примерно за секунду. Lorikeet поставила её в поддержку и отмечает, что стало быстрее и точнее.
Общий знаменатель простой: везде, где человек ждёт ответа и уже готов уйти, скорость важнее пары баллов в бенчмарке.
Сколько это стоит
Считаем на выходных токенах, потому что именно они дорогие. Миллион выходных токенов по обычной цене стоит $0,70, по стартовой $0,35.
Для агента, который делает 200 тысяч выходных токенов в день, это $140 по обычному тарифу и $70 по скидке. У Haiku 5.5 при $0,50 за миллион вышло бы $100, у Luna примерно столько же на коротких промптах.
То есть после окончания скидки Mercury 3 на выходе дороже конкурентов, и Inception не говорит, когда скидка закончится. На длинных входах картина другая: миллион токенов контекста у конкурентов стоит заметно дороже.
Отдельно стоит смотреть на реальную скорость. В каталоге OpenRouter медианная пропускная способность указана 228 токенов в секунду, а не 1 068. Это не обман, а разные условия замера: свой бенчмарк на своей инфраструктуре против общего шлюза с очередями. Но планировать нагрузку по 228 честнее.
Что с экосистемой
Кроме флагмана у Inception есть два узких продукта. Mercury Voice заточен под голосовых агентов и обещает время до первого токена меньше 170 мс, цена $0,40 и $1,50 за миллион, сейчас вдвое дешевле. Mercury Decide это модель для классификации и решений: вход $0,04, выход бесплатный, сейчас $0,02.
Важная деталь для тех, кто уже сидит на Mercury 2 или 2.5: новые пользователи их не получат, а действующие сохранят доступ до 15 ноября 2026 года. Дальше миграция.
Документация и 100 миллионов бесплатных токенов на старте есть на платформе Inception, описание API в доках. Модель также доступна через Baseten, если нужен свой контур.
Как проверить у себя
Не начинайте с миграции всего. Возьмите одну задачу, где задержка видна пользователю: голосовой ответ, подсказки в интерфейсе, шаг агента в браузере.
Прогоните на ней три модели: текущую, Mercury 3 и ближайшего конкурента по цене. Замерьте p50 и p95 задержки, стоимость на 1000 запросов и долю ответов, которые прошли ваш контроль качества.
Смотрите не на среднюю скорость, а на хвост. Если p95 не улучшился, выигрыш в бенчмарке вам ничего не даст.
И проверьте, как модель ведёт себя на длинном контексте. Миллион токенов это красивая цифра, но качество поиска по такому объёму у диффузионных моделей изучено хуже, чем у обычных.
Inception уже говорит, что начала обучать следующую модель и не собирается жертвовать скоростью. Если это правда, через полгода конкуренты будут догонять не по цене, а по архитектуре.