Содержание
Структурированный вывод — это когда LLM возвращает не свободный текст, а строгий JSON, XML или другую схему. Без него невозможно парсить ответы AI в коде, интегрировать LLM в пайплайны и строить надёжные AI-агенты. Четыре основные библиотеки — Instructor (Pydantic + retry), Outlines (constrained decoding на GPU), Guidance (шаблоны с контролем) и JSONFormer (лёгкий FSM) — решают эту задачу по-разному.
Почему JSON ломается?
LLM по умолчанию генерируют текст. Даже если попросить «верни JSON», модель может: забыть закрыть скобку, написать лишнюю запятую, вставить комментарий //, начать с пояснения «Вот ваш JSON:», завернуть ключи в одинарные кавычки. В 2026 году все топовые модели (GPT-4o, Claude Sonnet 4, Gemini 2.5 Pro, DeepSeek V3) поддерживают JSON mode — но он не гарантирует валидность схемы. Только то, что ответ будет синтаксически корректным JSON.
Проблема становится острой в продакшене: по данным Confident AI, до 15% JSON-ответов от LLM содержат структурные ошибки при сложных схемах с вложенными объектами и массивами. Для AI-агентов, где каждая упавшая парсинга — это потеря транзакции, 15% брака неприемлемы.
Поэтому индустрия пошла двумя путями. Первый — post-hoc валидация с повторными запросами (Instructor). Второй — constrained decoding, когда генерация сразу идёт в рамках заданной грамматики, и кривой JSON просто невозможен физически (Outlines, Guidance).
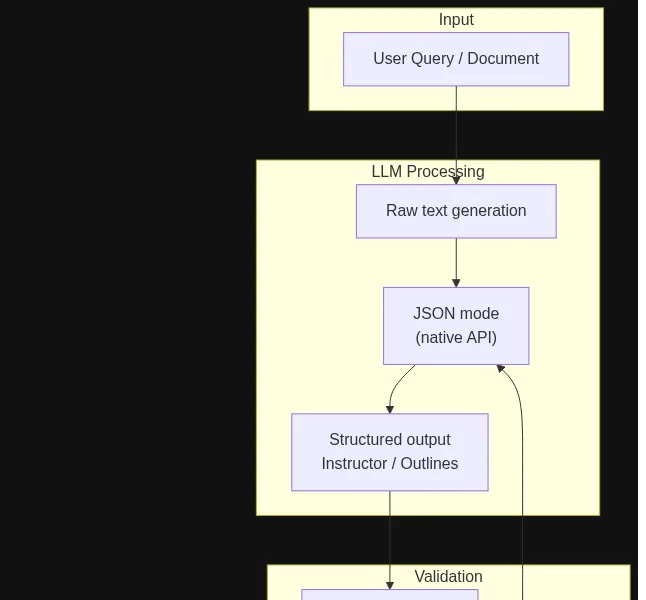
Pipeline structured output: raw text JSON mode Pydantic validation retry on error
Три способа получить JSON из LLM
Все существующие подходы к структурированному выводу можно разделить на три категории.
1. JSON mode провайдера
OpenAI, Anthropic и Google предоставляют нативный JSON mode через API. Вы передаёте response_format={ "type": "json_object" } (OpenAI) или response_format={ "type": "json_schema", "json_schema": ... } — и модель старается вернуть валидный JSON. Работает неплохо для плоских схем, но на вложенных объектах начинаются сбои. Плюс: ноль зависимостей. Минус: привязанность к провайдеру и отсутствие валидации — если JSON кривой, вы узнаете об этом только в парсере.
2. Post-hoc валидация с retry
Библиотека Instructor делает так: вы описываете Pydantic-модель → LLM генерирует JSON → Pydantic валидирует → если ошибка — повторный запрос с сообщением о проблеме. Просто и эффективно: до 99.8% валидных ответов после 2-3 retry. Работает с любым провайдером, поддерживающим function calling или JSON mode.
3. Constrained decoding (грамматики)
Outlines и Guidance идут дальше: они модифицируют процесс генерации на уровне токенов, «запрещая» модели выдать токен, который нарушит JSON-схему. Результат — гарантированно валидный JSON с первой попытки. Эффективность этого подхода доказана — Outlines использует методику индексирования регулярных выражений через конечные автоматы для работы на GPU (до 1000x быстрее наивной реализации). Минус: работает только для локальных моделей (через transformers или llama.cpp), не через API.
Instructor: Pydantic-first подход
Instructor (13 384 ★ на GitHub, 3M+ загрузок в месяц) — самая популярная библиотека для структурированного вывода на Python. Её концепция: «patch» для API-клиента, который перехватывает ответ и прогоняет его через Pydantic-валидацию.
pip install instructor # or: uv add instructorMinimal example:
import instructor
from pydantic import BaseModel

client = instructor.from_openai(OpenAI())

class UserExtract(BaseModel):
    name: str
    age: int

user = client.chat.completions.create(
    model="gpt-4o",
    response_model=UserExtract,
    messages=[{"role": "user", "content": "Ivan, 28 years"}]
)
print(user.name)  # Ivan
print(user.age)   # 28
Instructor делает три вещи под капотом: передаёт Pydantic-схему через response_format провайдера, получает JSON, валидирует его. Если валидация не прошла — формирует новый запрос с сообщением об ошибке. Поддерживает 15+ провайдеров: OpenAI, Anthropic, Google, Mistral, Ollama, DeepSeek, vLLM.
Ключевые возможности: Streaming-режим (частичные результаты с partial), Iterable (извлечение списков), модульные валидаторы, async-режим, повторные попытки с кастомной логикой. Есть биндинги для TypeScript, Go, Ruby, Elixir и Rust.
Outlines: constrained decoding на уровне токенов
Outlines (14 374 ★) — библиотека от команды .txt (dottxt.co), которую используют NVIDIA, Cohere и HuggingFace. Вместо post-hoc валидации Outlines модифицирует генерацию: на каждом шаге из словаря модели выбираются только те токены, которые соответствуют заданной JSON-схеме, регулярному выражению или контекстно-свободной грамматике.
pip install outlinesПример с JSON-схемой через Pydantic:
import outlines

class Person(BaseModel):
    name: str
    age: int

model = outlines.from_transformers(...)
result = model.generate(prompt, Person)
Outlines поддерживает: JSON по Pydantic-модели, function calling (из сигнатуры Python), регулярные выражения, грамматики (CFG), множественный выбор (через Literal["Yes", "No"]). Работает с локальными моделями (transformers, llama.cpp) и через серверные API (vLLM, Ollama).
Чем Outlines лучше Instructor: он гарантирует валидность — JSON не может быть кривым, потому что модель физически не может сгенерировать запрещённый токен. Чем хуже: не работает с OpenAI API напрямую (только с open-source моделями, которые вы хостите сами), более сложная установка, требует GPU для приличной скорости.
Guidance: контроль на уровне промпта
Guidance (21 531 ★) от Microsoft — это гибридный подход: вы пишете промпт с встроенными «управляющими конструкциями» {gen}, {select}, {#each}, которые ограничивают генерацию в реальном времени. Guidance не просто парсит ответ — он диктует модели, что и как генерировать, перехватывая каждый шаг.
pip install guidanceПример извлечения структуры:
import guidance

program = guidance("""
Извлеки информацию о пользователе:
{{#user~}}
Имя: {{gen 'name' stop="\n"}}
Возраст: {{gen 'age' pattern="\\d+"}}
{{~/user}}
""")

result = program()
print(result["name"])  # строка
print(result["age"])   # строка с цифрой
Guidance поддерживает: регулярные выражения, stop-токены, грамматики, role-based шаблоны (system/user/assistant), вложенные циклы, inline-валидацию. Работает с OpenAI API, Anthropic, HuggingFace Transformers, LlamaCpp, vLLM.
Сильная сторона Guidance: уникальная гибкость — вы контролируете не только формат вывода, но и сам процесс генерации: можно прервать модель на середине, подставить внешние данные, запустить валидацию между шагами. Слабая сторона: сложный синтаксис шаблонов, большая кодовая база, меньшее сообщество, чем у Instructor.
JSONFormer и constr: лёгкие альтернативы
JSONFormer (4 931 ★) — минималистичная библиотека для constrained decoding. Она работает по тому же принципу, что Outlines (конечный автомат на токенах), но проще — только JSON, без регулярных выражений и грамматик. JSONFormer подходит, когда нужно быстро получить гарантированный JSON без лишних зависимостей, но он медленнее Outlines на больших схемах и не обновлялся с 2024 года.
BAML (BoundaryML, 8 509 ★) — компилируемый подход на Rust: вы описываете схему на специальном языке (похожем на TypeScript), и BAML генерирует код для валидации на Python, TypeScript и Go. В отличие от Instructor, BAML выполняет всю валидацию на Rust — это на порядок быстрее для сложных схем с сотнями полей. Но требует отдельного шага компиляции.
Есть и платформенные решения: vLLM (Outlines встроен нативно), Ollama (JSON mode с Pydantic-схемой), llama-cpp-python (JSON-грамматики через response_format).
Сравнительная таблица
Какую библиотеку выбрать — зависит от вашего сценария. Вот ключевые параметры:
| Библиотека | Метод | ★ GitHub | Провайдеры | Retry | Stream | Когда брать |
|---|---|---|---|---|---|---|
| Instructor | Post-hoc + retry | 13.3K | OpenAI, Claude, Ollama, 15+ | Да | Да | API-first, продакшен, любой провайдер |
| Outlines | Constrained FSM | 14.3K | Локальные (transformers, GGUF) | Нет | Да | Локальные LLM, гарантированная схема |
| Guidance | Шаблоны + контроль | 21.5K | OpenAI, Claude, HF, vLLM | Нет | Да | Сложные промпты, генерация с остановками |
| JSONFormer | Constrained FSM | 4.9K | Локальные (HF) | Нет | Нет | Быстрый прототип, минимум зависимостей |
| BAML | Rust-компиляция | 8.5K | OpenAI, Claude, локальные | Да | Нет | Высокая производительность, сложные схемы |
Коротко
Структурированный вывод — не «фича», а необходимость для продакшена. Без него AI-агент, который должен записать данные в CRM или отправить запрос в API, будет ломаться в 10-15% случаев. Instructor даёт 99.8% валидных ответов за счёт retry — берите его для любого API-сценария. Outlines даёт 100% гарантию за счёт constrained decoding — берите для локальных моделей, когда цена ошибки высока. Guidance — если вам нужен тонкий контроль над процессом генерации.
Современная архитектура часто комбинирует оба подхода: Outlines или Guidance для чанков с критической структурой (финансовые данные, JSON для API) и Instructor для менее критичных полей, где допустимо несколько попыток.
Что ещё важно знать
JSON mode провайдера — это то же самое, что Instructor?
Нет. JSON mode (OpenAI, Anthropic, Google) только говорит модели «верни JSON» — но не валидирует схему. Instructor оборачивает JSON mode, добавляет Pydantic-валидацию и retry при ошибках. Без Instructor вы можете получить синтаксически корректный JSON с неверной структурой — например, поле age как строку вместо числа.
Outlines работает с OpenAI API?
Напрямую — нет. Outlines модифицирует процесс генерации на уровне токенов, что возможно только когда вы контролируете инференс (локальная модель через transformers, llama.cpp, vLLM). Для OpenAI API используйте Instructor — он работает через существующие endpoints без доступа к токенам.
Какая библиотека самая быстрая?
Для API-сценариев (OpenAI/Claude) Instructor не добавляет заметной задержки — retry случаются редко. Для локальных моделей Outlines быстрее Guidance на больших схемах, потому что работает на GPU через индексированные конечные автоматы. Guidance медленнее, но даёт больше контроля. BAML — самый быстрый на Rust, но требует компиляции.
Можно ли комбинировать несколько библиотек?
Да. Типичная связка: Outlines для локального препроцессинга (извлечение сущностей с гарантированной структурой) + Instructor для API-запросов (генерация ответов с retry). Guidance можно добавить для сложных мультишаговых промптов — например, когда следующий шаг генерации зависит от предыдущего.
Что выбрать для хакатона/прототипа?
Instructor. pip install instructor, одна строка client = instructor.from_openai(openai_client), и вы уже получаете валидированный JSON. Никаких грамматик, компиляции и GPU — только Pydantic-модель и промпт. Другие библиотеки добавляйте, когда потребуются гарантии или производительность.