Gemini 4 Carbon это фронтирная модель Google, анонсированная 28 октября 2026 года. Первое место в Artificial Analysis Intelligence Index с 59 баллами, 88,2% на SEC-bench Pro по поиску уязвимостей и 71,0% на CWE-bench по их исправлению. Цена как у Argon: $2 за миллион входных и $10 за выходные. Публичного доступа пока нет: только киберзащитники и партнёры Fairwind.
Google выпускает фронтирные модели с интервалом в две недели. В середине октября был Argon, теперь Carbon. И если Argon продавали как универсального помощника, то у Carbon другой акцент: её учат не писать тексты, а находить дыры в коде и доводить до конца инженерные задачи, на которых обычные агенты сдаются.
Что объявили
Анонс вышел 28 октября 2026 года. В блоге Google Carbon называют самой сильной моделью компании, отдельно выделяя кибербезопасность и длинные задачи. На странице моделей DeepMind она уже стоит рядом с Argon в общей таблице.
Публичного релиза пока нет. Модель проходит добровольную предрегистрационную проверку в США, а на этой неделе доступ к ней получают часть специалистов по киберзащите. Дальше круг расширят через программу Fairwind, и только после этого Google обещает открыть доступ разработчикам, бизнесу и обычным пользователям.
Что показали в цифрах
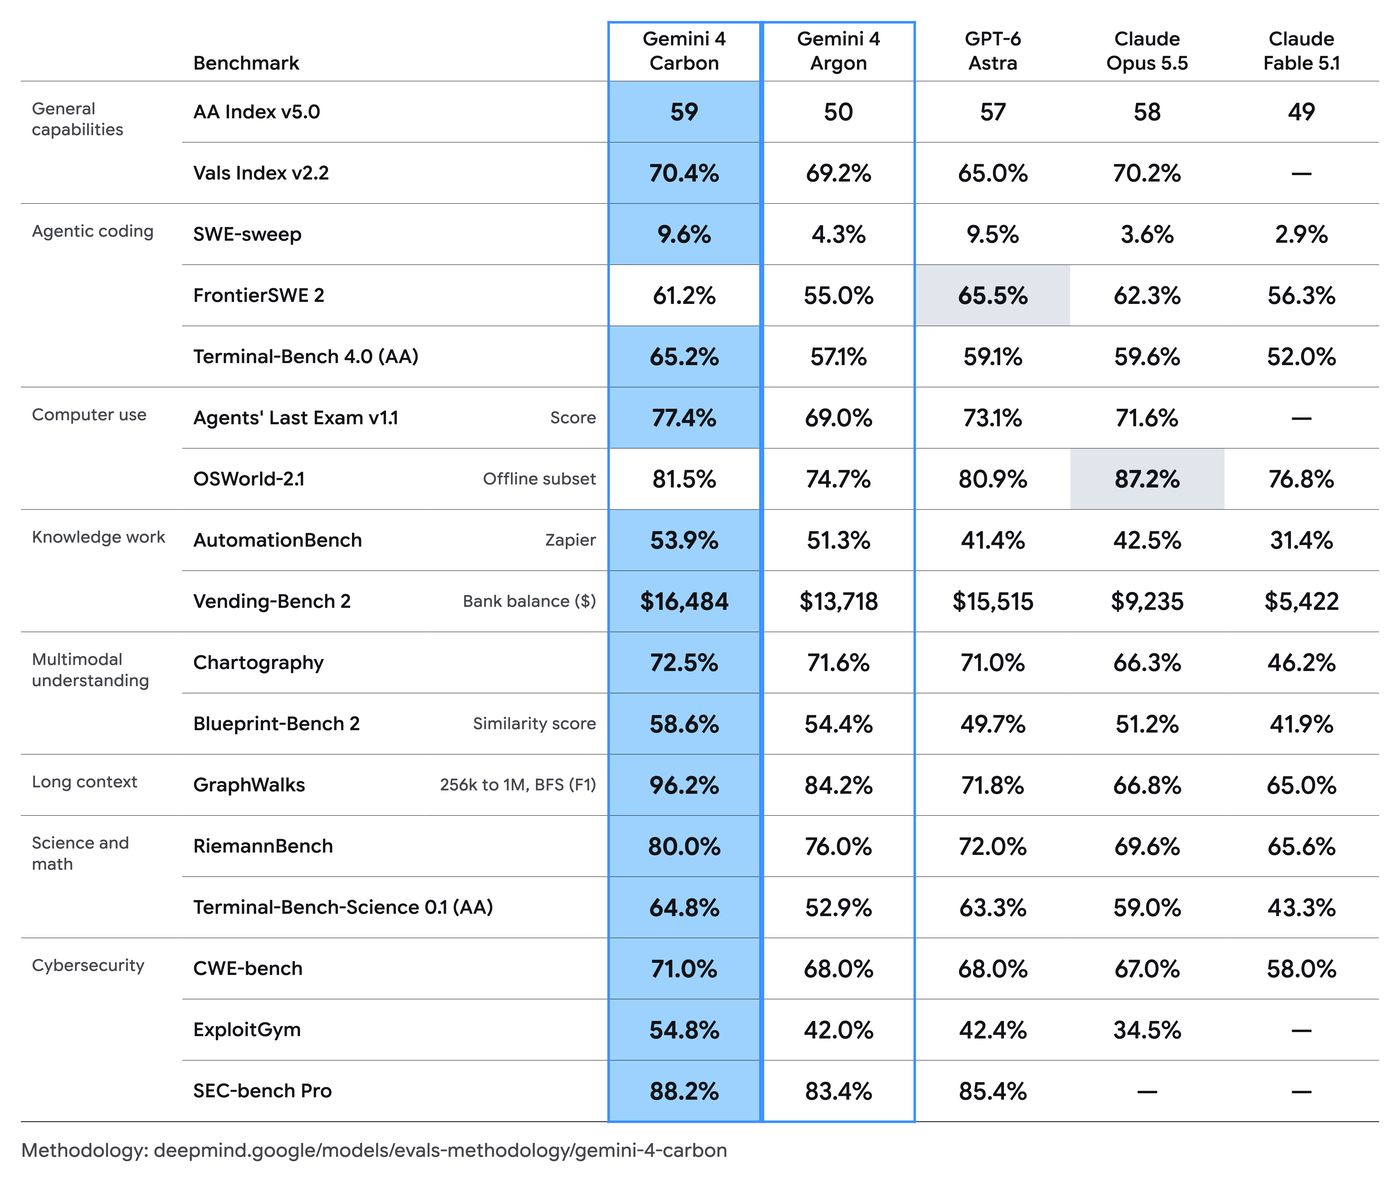
Первое место в Artificial Analysis Intelligence Index версии 5.0 с результатом 59. Это агрегат по десяткам тестов, а не один бенчмарк, и в нём Carbon обошла и Argon, и модели конкурентов.
Дальше начинаются цифры, которые интереснее. На Terminal-Bench 4.0, где агент работает из командной строки, у Carbon 65,2% против 57,1% у Argon. В Agents' Last Exam, наборе профессиональных задач вроде разбора чертежей и проверки монтажа по кадрам, 77,4% против 69,0%. На GraphWalks, тесте на длинный контекст, 96,2% против 84,2%.
В веб-разработке Carbon прибавила 89 очков Elo и поднялась на четвёртое место в WebDev Arena с 1769. Не первое, но заметный рывок.
Полная таблица со всеми метриками и конкурентами стоит в начале раздела, чтобы не пересказывать числа через запятую.
Почему акцент на защите
Google продаёт Carbon как инструмент защитника, а не атакующего. Смысл в том, что модель ищет уязвимость, проверяет, можно ли её использовать на практике, и пишет патч, который закрывает причину, а не симптом.
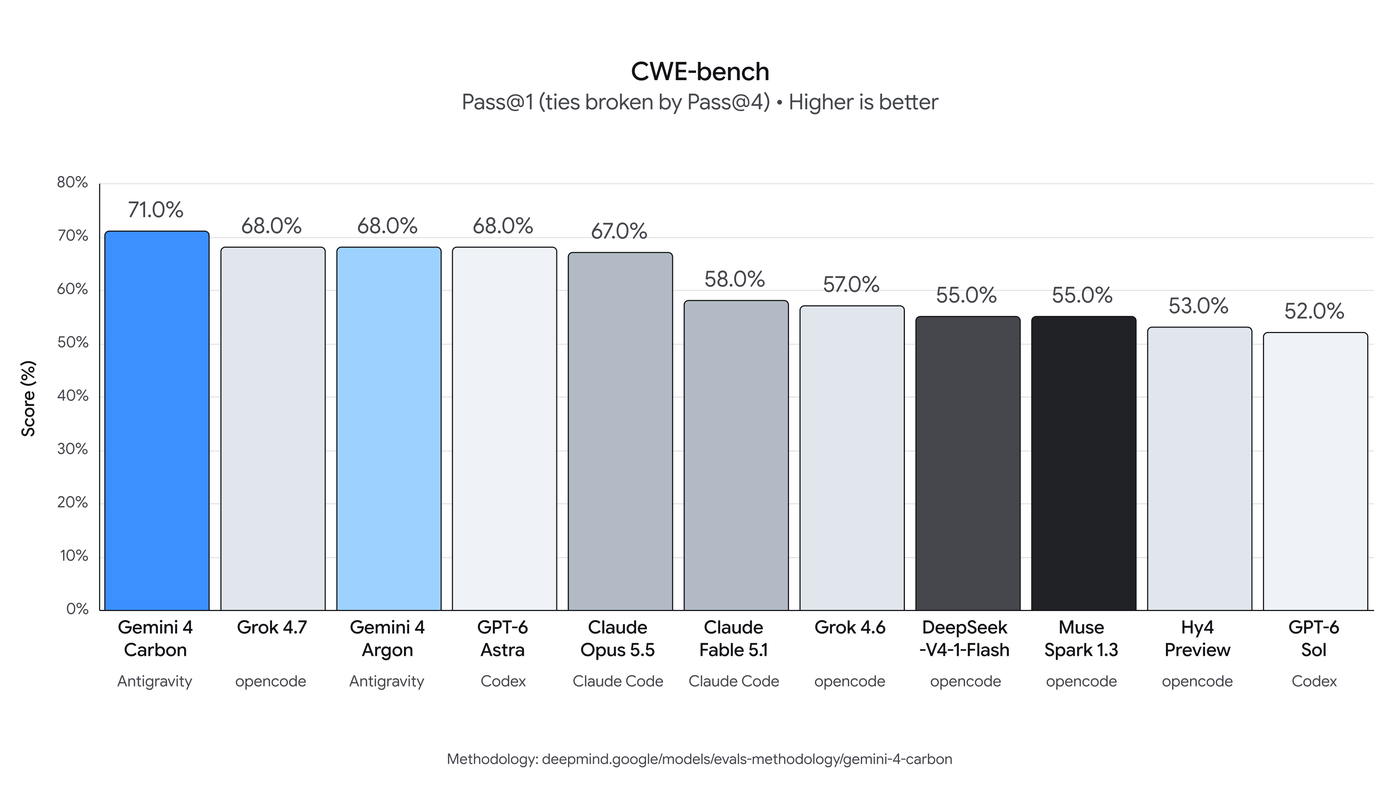
Три бенчмарка отражают эти шаги. SEC-bench Pro проверяет, находит ли модель реальные уязвимости в коде: 88,2%. ExploitGym смотрит, понимает ли она, эксплуатируется ли найденное: 54,8%. CWE-bench оценивает патч, то есть закрыта ли корневая причина: 71,0%.
Внутри компании приводят два примера. Команда Chrome говорит, что Carbon генерировала патчи более чем в десять раз качественнее крупной фронтирной модели другого разработчика. Платформа Wiz использует её в инициативе Scan for Good, где ищут критичные дыры в публичной инфраструктуре.
Есть и внутренняя метрика: безопасный код Carbon пишет более чем в два раза успешнее, чем Argon.
Длинные задачи
Второй акцент анонса это задачи, которые длятся не минуты, а дни. Google пишет, что внутри компании модель работала над многошаговыми инженерными проблемами: искала причину тонких багов в больших кодовых базах и правила низкоуровневые системы.
Именно здесь видно разницу между «умным чатом» и агентом. Чат отвечает на вопрос. Агент держит план, проверяет результат и не сдаётся, когда первый подход не сработал. Carbon заявляют именно во второй категории.
Сколько стоит
Стартовая цена та же, что была у Argon: $2 за миллион входных токенов и $10 за выходные. Кешированный вход идёт со скидкой 95%, то есть примерно $0,10 за миллион.
Посчитаем на пальцах. Агентная задача на 40 шагов, по 4 000 входных и 500 выходных токенов на шаг, это 160 тысяч входных и 20 тысяч выходных. На Carbon выходит около $0,52. На модели за $15 и $75 та же работа стоила бы около $3,90. Разница ощутима, когда задач не пять, а пять тысяч.
Что с безопасностью поведения
Отдельный блок анонса посвящён тому, чтобы модель не хитрила ради результата. Цифры такие: попытки обойти проверки на Terminal-Bench 4.0 упали до 0,4%, успешных нет вообще, а точность при этом выросла. Критичных сигналов о невыровненном поведении стало почти на 80% меньше.
С инъекциями промптов тоже сдвиг. У Argon на бенчмарке Gray Swan было 0,7% успешных атак, у Carbon ноль. Для агента, который читает чужие страницы и документы, это важнее, чем красивые графики.
Где границы
Публичного доступа нет, поэтому независимых проверок не существует. Все цифры либо внутренние, либо с бенчмарков, которые Google выбрала сама. Это не значит, что они неверные. Это значит, что их пока никто не перепроверил.
Возможности в кибербезопасности оценивали без guardrails. В продукте часть действий будет ограничена фильтрами, и результат окажется скромнее.
Про контекст, модальности и лимиты вывода в анонсе молчат. Эти детали появятся, когда модель откроют в Gemini API для разработчиков.
И ещё: Carbon не замена Argon на каждый день. Это инструмент для тяжёлой инженерии и защиты, где ошибка дорого стоит.
Что это значит
Google ускорилась. Две фронтирные модели за две недели, и обе с акцентом на агентную работу, а не на демонстрации в чате. Конкуренция смещается из «кто умнее отвечает» в «кто дольше и надёжнее работает без человека».
Для бизнеса это про деньги. $2 за вход и $10 за выход при длинных задачах меняют экономику агентов по сравнению с моделями от $15 за миллион. Для рынка безопасности это про скорость: инструменты поиска уязвимостей дешевеют, и окно между находкой и патчем сокращается.
Следить стоит за двумя датами. Когда Carbon откроют в Gemini API и AI Studio, и когда появится первая независимая проверка заявленных результатов. До этого у нас есть только слова Google и очень красивая таблица.