REA расшифровывается как Reverse Engineer Anything. Это бесплатный инструмент с открытым кодом, который подключает реверс-инжиниринг к вашему ИИ-агенту. Агент открывает готовое приложение, находит нужную функцию и показывает код с привязкой к файлам и строкам. За день с ним можно разобрать чужую функцию, собрать свою версию и проверить поведение на прототипе.
Что это за инструмент
REA работает в двух видах: как команда в терминале и как MCP-сервер, то есть подключаемый инструмент для агента. Во втором случае вы просто пишете агенту задачу, а он сам вызывает нужные инструменты.
Внутри набор движков под одним общим интерфейсом. Для скомпилированных программ это декомпиляторы, для приложений на JavaScript и Electron статический разбор, для браузерных сценариев подключение к странице. Агенту не нужно знать, какой движок сработал: он получает код, ссылки и оценки уверенности.
Что важно для бизнеса. Анализ идёт локально, приложение никуда не загружается. Инструмент показывает и вывод, и основание: где в файле лежит функция, какая строка её вызывает, что осталось непроверенным. Если доказательств нет, он пишет «неизвестно», а не придумывает ответ.
Чего он не делает: не восстанавливает оригинальные исходники и не клонирует приложение целиком. Задача другая: объяснить механику.
Как он работает
Установка занимает одну команду. Дальше агент видит инструмент и может им пользоваться. Формулировка задачи звучит как обычный запрос: «Разбери, как в этом приложении работает копирование с сохранением форматирования. Покажи код на каждом шаге и объясни, что происходит».
Агент открывает приложение, находит нужную функцию, идёт по вызовам и возвращает цепочку с адресами и фрагментами кода. Вы читаете не пересказ, а конкретные места в файлах.
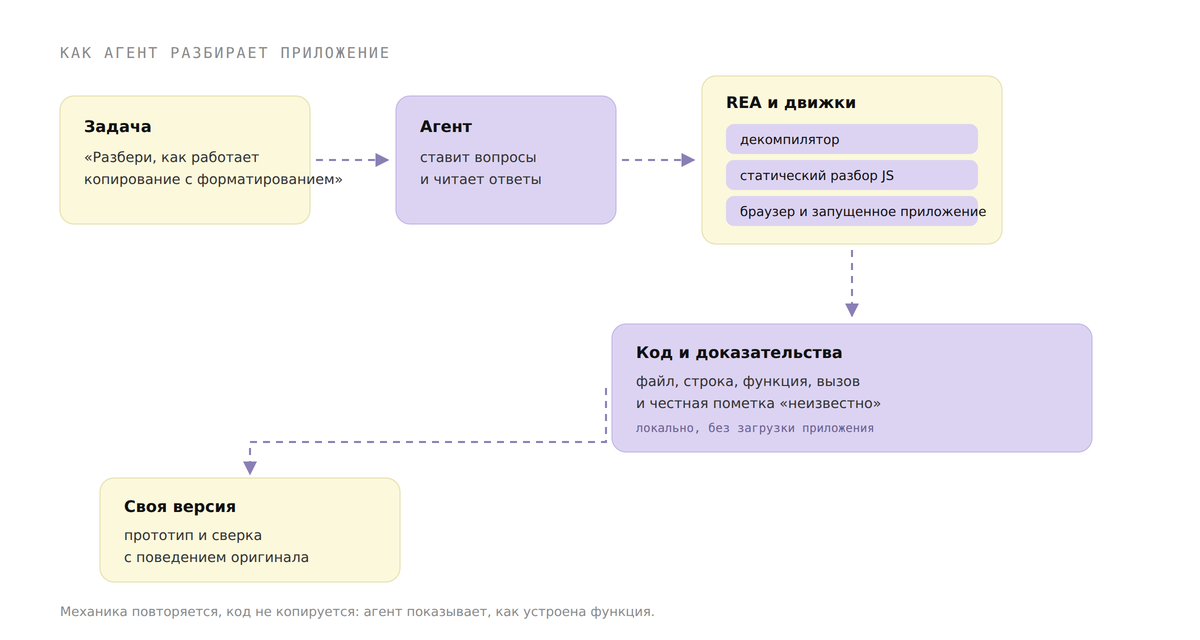
Схема: путь от задачи до проверенной версии. N202, октябрь 2026
Кейс: копирование с сохранением структуры
Возьмём функцию, которую часто просят клиенты. Пользователь выделяет блок с заголовком, списком и таблицей, копирует и вставляет в письмо. Если положить в буфер просто HTML, структура потеряется: таблица приедет набором строк, список абзацами.
Разбор показывает второй слой. Страница вызывает метод, мост передаёт сообщение главному процессу, обработчик проверяет источник и отдаёт данные в системный буфер. Рядом лежит скрытая метка в HTML и локальное хранилище структуры по этому идентификатору. При вставке приложение читает метку, находит запись и собирает блоки обратно.
Это не секретный алгоритм. Это инженерное решение из двух частей: идентификатор в буфере и хранилище структуры. Повторить его можно у себя, не копируя чужой код.
Как выглядит день
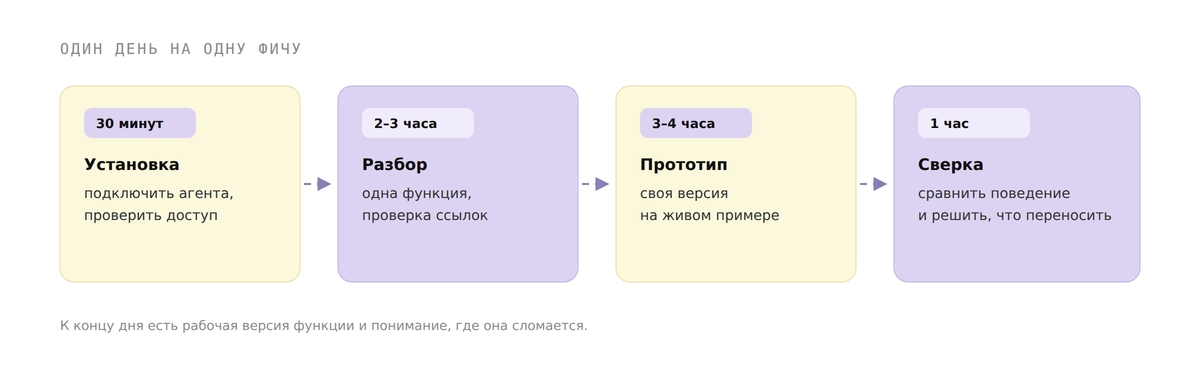
План дня: от установки до сверки. N202, октябрь 2026
План без героизма, на одного инженера.
- 30 минут: поставить инструмент, подключить к агенту, проверить, что он видит приложение.
- 2–3 часа: разбор одной функции. Агент проходит цепочку, вы проверяете места, на которые он ссылается.
- 3–4 часа: своя версия на прототипе. Не продакшен, а проверка механики на живом примере.
- 1 час: сравнить поведение с оригиналом и решить, что переносить в основной продукт.
К концу дня у вас есть работающая версия функции и понимание, где она сломается. Не «месяц на копирование», а один цикл.
Что с этим делать бизнесу
После разбора можно принять три решения. Выбрать свой формат хранения структуры, а не тащить чужой. Ограничить вставку своим приложением через проверку источника. И пересчитать сроки: неделя на формат и пара дней на буфер.
Главная ценность здесь не код. Код конкурента закрыт лицензией, а механика нет. Вы покупаете понимание, как устроена функция, и на нём строите свою версию.
Второй сценарий: приёмка чужого кода
Та же процедура закрывает бытовые задачи. Принять проект у подрядчика. Разобраться в legacy перед миграцией. Оценить покупку приложения.
Я прогнал её на учебном приложении на шесть файлов: заметки и кнопка экспорта. Разбор занял 5,4 секунды. На выходе отчёт на 456 КБ и 21 находка: канал notes:export, функция сборки CSV, обработчик в главном процессе.
Дальше одна ручная проверка. Что будет, если в заголовке заметки есть кавычки. Ответ оказался таким:
id,title
1,"Hello, ""REA"""
Поле не развалилось, кавычки удвоились. Для продукта это скучная, но важная деталь. Для бизнеса это готовый сценарий приёмки: куда приложение пишет файлы, какие поля отдаёт, что делает с кривыми данными. Три вопроса, на которые можно ответить до подписания акта.
Где ломается
Для приложений на JavaScript и Electron отдельный движок не нужен. Для скомпилированных программ понадобится декомпилятор, бесплатный вариант есть, но его придётся поставить отдельно. Без него разбор просто не запустится.
Большое приложение не разбирается за секунды. Мой пример на шесть файлов занял 5,4 секунды, реальный продукт будет в тысячи раз больше. Время уходит на чтение отчёта и проверку, а не на саму команду.
И ещё: статический разбор не показывает, что код реально исполняется. Поведение снимается отдельно, на запущенном приложении. Если нужна именно динамика, это второй шаг, а не первый.
Где границы
Разбирать своё приложение, legacy-код заказчика, open-source проект или софт с разрешения владельца нормально. Обход защиты, взлом лицензионных проверок и вытаскивание данных без согласия сюда не входят.
REA показывает, как устроен код. Разрешения пользоваться им он не даёт. Ответственность остаётся на том, кто ставит задачу.
Чек-лист на день
- Функция одна и понятна пользователю.
- Есть доступ к приложению: файл, установленная версия или распакованный пакет.
- Агент подключён, движок проверен.
- Вывод проверен на прототипе, а не принят на веру.
- Решение принято по механике, а не по чужому коду.
Что в итоге
REA не замена инженеру и не кнопка «скопировать конкурента». Это способ за день получить карту чужой функции и проверить её на своём прототипе. Для стартапа этого достаточно, чтобы догнать конкурента по конкретной возможности, а не переписывать продукт целиком.