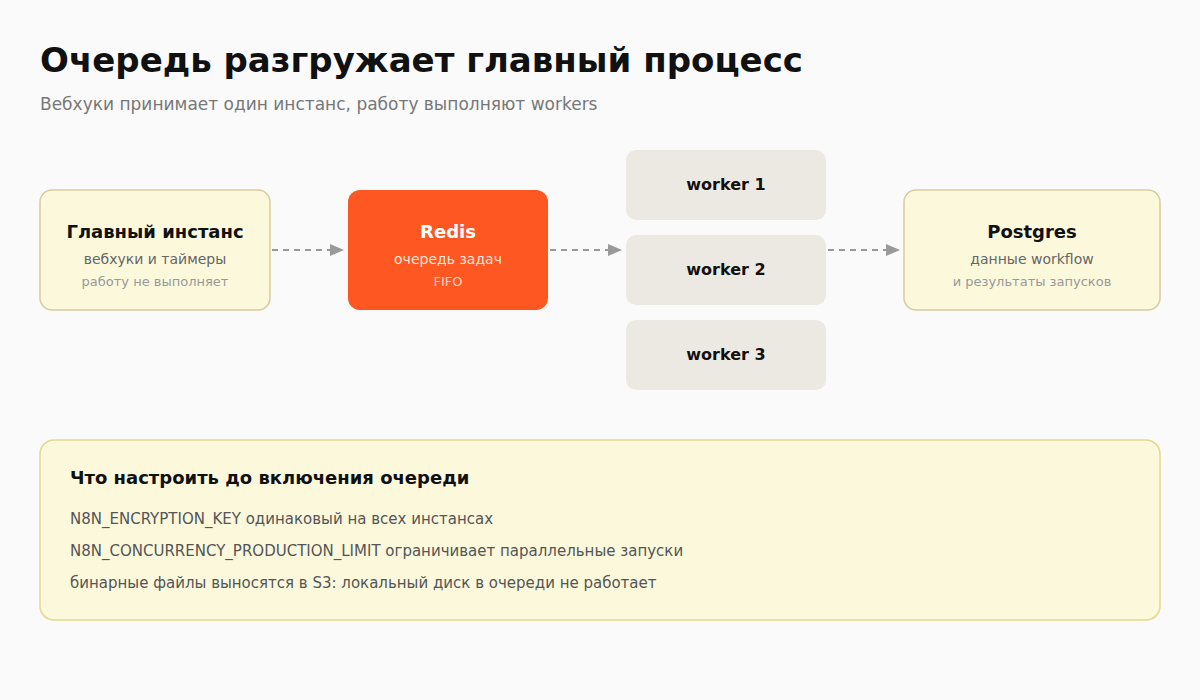
n8n держит нагрузку, когда главный инстанс только принимает события, а работу выполняют workers через очередь Redis. До продакшена нужны одинаковый N8N_ENCRYPTION_KEY на всех нодах, лимит N8N_CONCURRENCY_PRODUCTION_LIMIT, error workflow и идемпотентные повторы. Без этого процесс разваливается на первой сотне заявок в день.
n8n легко запустить и легко превратить в хрупкую конструкцию. Пять workflow, склеенных вебхуками, работают, пока заявок мало. На сотне в день начинаются дубли, потерянные письма и «а почему это не сработало».
Разберём, как собрать оркестрацию, которая держит нагрузку и не требует дежурного.
Когда n8n хватает, а когда нужен код
n8n хорош там, где процесс меняется чаще, чем нагрузка: интеграции с десятком сервисов, ручные исключения, быстрые правки без релиза.
Если у вас миллион событий в сутки, жёсткие SLA и сложная бизнес-логика, n8n останется дирижёром, но тяжёлую часть лучше вынести в сервис на Python. Нормальная схема: n8n принимает событие, вызывает ваш сервис, обрабатывает результат и раскладывает по системам.
Плохая схема: тащить в n8n всё: расчёты, парсинг больших файлов, работу с бинарниками. Он это умеет, но не для этого сделан.
Как выглядит рабочий процесс
Типичный сценарий: пришла заявка → агент её квалифицировал → карточка в CRM → уведомление менеджеру → письмо клиенту.
В n8n это один workflow из трёх блоков: приём, обработка, публикация результата. Вот как это выглядит в интерфейсе:
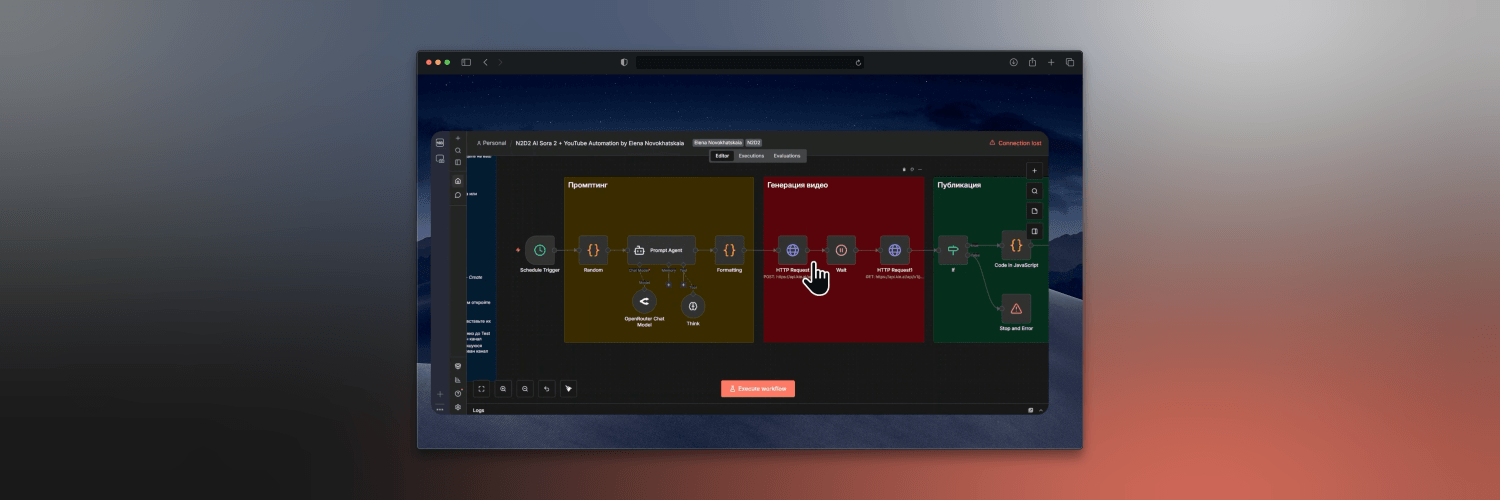
Каждый блок можно вынести в отдельный под-workflow. Это не украшательство: под-workflow вызывается из родительского через узел Execute Workflow, и его запуски не считаются в лимитах тарифа. Большой процесс разбивается на части, которые можно тестировать и менять отдельно.
Обычный режим и очередь
По умолчанию n8n работает в обычном режиме: один процесс принимает вебхуки и сам выполняет workflow. Пока нагрузка небольшая, этого достаточно.
Когда заявок становится много, включают queue mode. Схема такая:
- главный инстанс принимает вебхуки и таймеры, но не выполняет работу;
- он кладёт задачу в Redis, где лежит очередь;
- свободный worker забирает задачу, идёт в базу за данными workflow и выполняет;
- результат пишется в базу, Redis получает сигнал, главный инстанс видит завершение.
Workers добавляются и убираются по нагрузке. Но есть две ловушки, о которых узнают в первый инцидент. Ключ шифрования N8N_ENCRYPTION_KEY должен быть одинаковым на всех инстансах, иначе worker не прочитает креды. И очередь не работает с бинарными файлами на локальном диске: для файлов нужен S3.
Сколько запусков держать одновременно
В обычном режиме n8n не ограничивает число параллельных продакшн-запусков. Это и есть причина, по которой инстанс «зависает»: слишком много одновременных выполнений душат event loop.
Лимит задаётся переменной N8N_CONCURRENCY_PRODUCTION_LIMIT. Например, 20:
export N8N_CONCURRENCY_PRODUCTION_LIMIT=20Что важно знать про этот лимит: он действует только на продакшн-запуски из вебхуков и триггеров, ручные и под-workflow не считаются. Лишние запуски встают в очередь и выполняются по порядку. Запуск из очереди нельзя повторить, а отмена удаляет его совсем. В queue mode тот же параметр управляет параллельностью worker, если не задан флаг --concurrency.
Подробности в документации по контролю параллельности.
Ошибки: планка, ниже которой нельзя
Первый уровень: retry на узле: в настройках узла включается Retry On Fail, задаётся число попыток и пауза. Это спасает от таймаутов внешнего API, но не от логических ошибок.
Второй уровень: error workflow. Он запускается, когда выполнение упало, и начинает с узла Error Trigger. Дальше вы решаете: написать в Slack, создать тикет, положить данные в таблицу разбора.
Третий уровень: идемпотентность. Любой повтор должен быть безопасен: проверка по order_id или message_id перед созданием сущности. Без этого retry превращается в дубли заказов и писем.
И четвёртый, который чаще всего забывают: таймауты. Внешний сервис может не ответить никогда. Ставьте ограничение на узел и общий таймаут процесса, иначе worker будет держать задачу, пока не кончится память.
Наблюдаемость
Минимум, с которого стоит начинать: список Executions, фильтр по статусу и error workflow с уведомлением.
Дальше экспорт логов во внешнюю систему и метрики: сколько запусков в минуту, сколько падений, сколько в очереди, сколько ждёт дольше минуты. Без этого вы узнаете о проблеме от клиента, а не от мониторинга.
Ещё одна практика: хранить workflow в git. n8n умеет экспортировать их в JSON, и это единственный способ понять, что изменилось между «работало» и «сломалось».
Безопасность и обновления
Креды хранятся в базе в зашифрованном виде, ключ шифрования в переменной окружения, а не в репозитории.
Доступ к самому n8n закройте от внешнего мира: вебхуки отдельно, редактор отдельно, через VPN или basic auth. Открытый редактор n8n в интернете даёт доступ к вашим токенам.
Обновляйтесь осознанно. Мажорные версии меняют поведение узлов, поэтому сначала стенд с копией базы, потом прод.
Чек-лист перед продакшеном
- Включён queue mode, если нагрузка выше сотни запусков в день.
- Задан
N8N_CONCURRENCY_PRODUCTION_LIMIT. - Настроен error workflow и проверено, что он реально приходит.
- Все внешние вызовы с retry и таймаутом.
- Повторные запуски не создают дублей.
- Файлы вынесены в S3, если работаете с бинарниками.
- Workflow экспортируются в git.
- Редактор закрыт от публичного доступа.
- Есть дашборд: очередь, ошибки, длительность.