Hy-Nomas это открытая модель Tencent Hunyuan под Apache 2.0: она генерирует видео сегментами и принимает текст и траекторию камеры на каждом шаге. Восемь шагов денойзинга, 720×1280 при 24 fps, запуск на одной RTX 4090 в INT8. Ниже: как устроен пайплайн, что показывает бенчмарк на 280 кейсов и где модель теряет сцену.
Обычный видеогенератор выдаёт клип целиком. Если на середине выяснилось, что камера стоит не там, приходится перегенерировать всё и надеяться, что персонаж останется похожим на себя. Для серии роликов это дорого и бессмысленно.
Hy-Nomas от Tencent Hunyuan устроена иначе. Она генерирует мир сегментами и принимает новые указания на каждом шаге: можно повернуть камеру, добавить объект, сменить время суток и продолжить с того же места.
Что такое Hy-Nomas
Открытая модель генерации видео, опубликованная 21 октября 2026 года под лицензией Apache 2.0. Веса, код инференса, обучения и разметки лежат на Hugging Face и GitHub, работающее демо доступно на hy-nomas.hy.tencent.com.
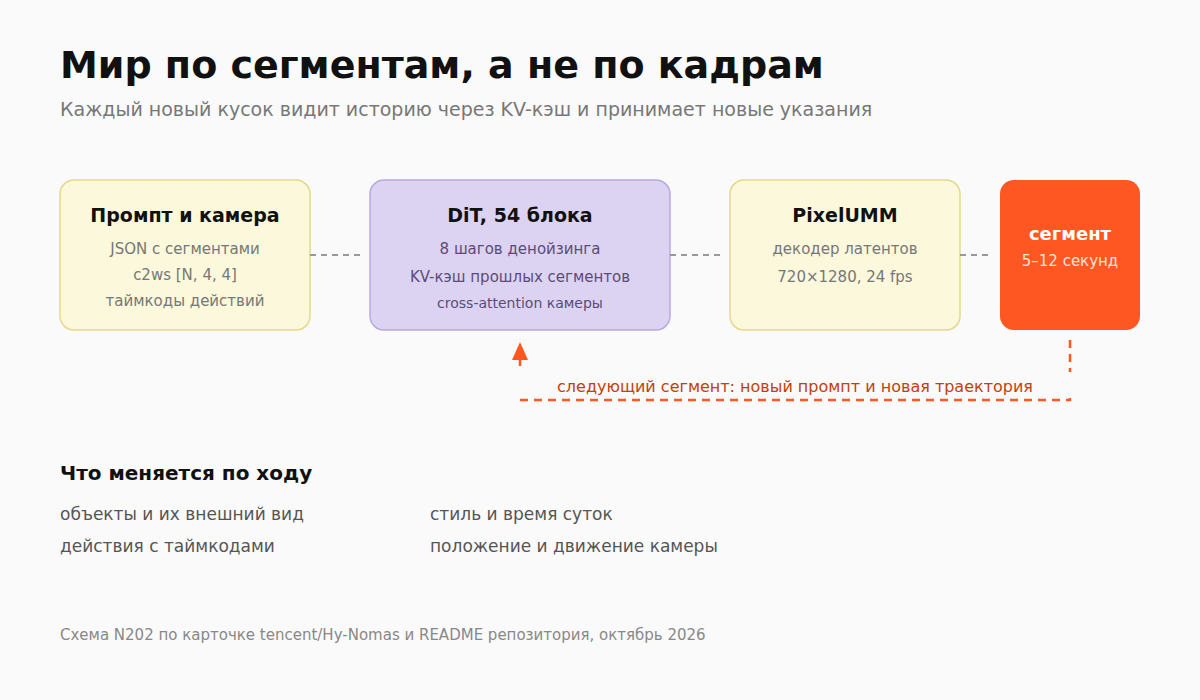
Внутри четыре части. Текстовый энкодер на базе Qwen2.5-VL-7B, диффузионный трансформер на 54 блока MMDiT, модули камеры и декодер PixelUMM. Модель генерирует в сжатом латентном пространстве и переносит KV-кэш между сегментами, поэтому новый кусок знает, что было раньше.
Разрешение 720×1280 при 24 кадрах в секунду. Дистиллированный режим работает за восемь шагов денойзинга. Сегмент в примерах кода длится пять секунд, в галерее встречаются куски по двенадцать.
Генерация по сегментам, а не по кадрам
Модель идёт вперёд не по кадрам, а по сегментам. Каждый новый кусок стартует из гауссова шума и смотрит на историю через KV-кэш. Внимание причинное: при генерации сегмента модель не заглядывает в будущее.
Что это даёт на практике. Получасовой ролик не нужно держать в памяти целиком, достаточно продолжать мир. Промпт можно менять по ходу: на первом сегменте описать лес, на третьем добавить дождь, на пятом развернуть камеру к небу. Сколько дублей вы сейчас тратите на один проход камеры?
Что это ломает. Чем длиннее история, тем больше кэш. В полной конфигурации память растёт с каждым сегментом, поэтому для длинных сцен есть режим со скользящим окном: старое уходит в архив на CPU, а на видеокарте остаётся ограниченный контекст.
Камера отдельным входом
Это главное отличие от «камера в промпте». Траектория здесь подаётся файлом: матрицы камера-в-мир c2ws размером [N, 4, 4] и внутренние параметры [N, 3, 3]. Модель нормализует их, группирует по четыре кадра и сжимает в 64-мерный вход. Дальше видео-токены на каждом блоке MMDiT запрашивают эти признаки через cross-attention.
На пальцах: вы задаёте не «камера облетает героя», а конкретное движение с числами. Хотите наезд, отъезд или проезд мимо витрины, строите траекторию и прикладываете её к промпту. Утилиты для генерации npz-файлов лежат в репозитории.
Почему это важно для контента. Один и тот же мир можно снять с трёх точек и получить три вставки для ролика, не собирая сцену заново. Для рилс это дешевле, чем генерировать три независимых клипа, где фон и свет не совпадут.
Промпт: сцена и её изменения
Запрос описывается JSON-файлом. В нём есть стиль, точка обзора, список объектов и сегменты с таймкодами. Для каждого сегмента указывается, что меняется и какие действия происходят.
{
  "Style": "Cinematic fantasy",
  "perspective_view": "Third-person view",
  "subject_list": [
    {"subject_id": "fox", "display_name": "a small orange fox"}
  ],
  "segments": [
    {
      "start_time": "00:00.000",
      "end_time": "00:05.000",
      "visual_description_long": "A fox on a stone path in a glowing forest."
    },
    {
      "start_time": "00:05.000",
      "end_time": "00:10.000",
      "description_change": "Blue flowers open beside the path.",
      "contained_actions": [{
        "start_time": "00:05.000",
        "end_time": "00:10.000",
        "action_description": "The fox passes and looks around."
      }]
    }
  ]
}
Дальше вызов пайплайна. В примере из документации два сегмента по пять секунд, высота 704, ширина 1280, 24 кадра в секунду и четыре шага инференса.
videos = pipe(prompt=[json.dumps(p) for p in prompts],
              height=704, width=1280, num_frames=240,
              segment_latent_lengths=[30, 30], fps=24,
              num_inference_steps=4)
export_to_video(videos[0], "hy_nomas_video.mp4", fps=24)
Логика простая: описали мир, нарезали на сегменты, для каждого указали изменение. Чем точнее описание действия и таймкод, тем меньше модель додумывает.
Одна RTX 4090 и что это значит
Официально есть конфигурация для одной GeForce RTX 4090. В ней веса DiT и KV-кэш хранятся в INT8, вычисления идут в BF16, декодер PixelUMM квантован в FP8, а часть модулей выгружается в CPU. Плюс скользящее окно истории и ядра FlexAttention.
Это не значит, что модель летает на бытовой карте. Это значит, что порог входа ниже, чем у конфигураций на восемь B200, которые нужны для веб-демо с онлайн-обновлением промпта. Видеоинференс и интерактивная демонстрация это разные нагрузки, и в карточке модели это разделено явно.
Для студии вывод простой: тесты и раскадровки можно гонять на одной карте, а продакшн с живым управлением требует нескольких GPU и отдельного сервиса Nomas-PE, который превращает инструкции в структурированные промпты.
Hy-Nomas-Bench: 280 кейсов
Вместе с моделью выложили бенчмарк из четырёх наборов и 280 тестовых случаев. Он проверяет многоходовое текстовое управление, навигацию камерой, смешанные сценарии и пространственную память.
Что это даёт практически. Вы можете прогнать свою сцену по методике и увидеть, где модель теряет объект: при повороте камеры, после смены описания или на длинной истории. Это честнее, чем смотреть нарезку красивых кадров из галереи.
Где модель плывёт
Первое: дрейф мира. После десяти сегментов фон может измениться, а объект потерять детали. Чем длиннее история, тем заметнее.
Второе: память. Полный кэш растёт, скользящее окно помогает, но старые детали сцены уходят из активного контекста.
Третье: камера. Траектория задаётся числами, и если она не согласована с длительностью и частотой кадров, движение получится рваным.
Четвёртое: скорость. Восемь шагов это не мгновенно, а на одной карте в INT8 ожидание сегмента ощутимое. Для черновых сцен терпимо, для потока роликов нужен расчёт бюджета времени.
С чего начать
Сначала демо. Запустите мир на сайте, пройдитесь камерой, посмотрите, как модель держит сцену на третьем и пятом повороте.
Потом локально. Скачайте веса, возьмите конфиг для одной карты, прогоните пример с лисой из документации. Если получилось, замените промпт на свой и добавьте траекторию.
И только потом думайте про серию. Первые пять роликов почти всегда уходят на то, чтобы понять, какие описания модель понимает, а какие игнорирует. Это нормальная цена входа.
Апскейл и цветокор потом. Сначала сцена, камера и монтаж, иначе красивая картинка останется набором несвязанных кусков.